Feynman AI 是什麼?它算終端機嗎?開源 AI 研究代理白話入門,跟 ChatGPT、Claude Code 差在哪
Feynman AI 是一套開源的「AI 研究代理」:你在終端機裡丟一個研究問題給它,它會自己去論文資料庫和網路找資料、讀完、寫成一份附引用來源的報告,再派另一個 AI 角色回頭核對每一條引用有沒有對上。終端機只是它住的地方,Feynman 本身是一支在終端機裡執行的程式,就像 Word 是一支在 Windows 裡執行的軟體。
這個問題是我們團隊最近被問到的:有人在網路上看到工程師用 Feynman 跑研究,畫面黑底綠字、還有一個大大的像素風 logo,第一眼以為是某種新的終端機。我們把官方 GitHub 專案的 README、說明文件和一千多行的 release notes 從頭讀了一遍,把它整理成給第一次聽到的人看的版本:它是什麼、怎麼運作、跟 ChatGPT 和 Claude Code 差在哪、誰適合用、怎麼開始試,以及用之前要先想清楚的風險。
先說名字:Feynman 很容易跟物理學家費曼、或是「費曼學習法」搞混。這篇講的是 GitHub 上那個由 Companion 團隊維護的 AI 工具,官方自己的一句話介紹是「The open source AI research agent」,也就是開源的 AI 研究代理。
Feynman AI 是什麼?一句話:住在終端機裡的 AI 研究小組
一句話:Feynman 把「找資料、讀論文、寫報告、核對引用」拆給幾個 AI 角色分工完成,你在終端機下一行指令,它把成果寫成檔案存在你自己的電腦裡。
用一個研究小組來想像最好懂。researcher 像跑圖書館的研究助理,負責把相關論文和網頁找回來;writer 像執筆的人,把整理好的筆記寫成文章;verifier 像核對腳註的編輯,一條一條打開來源確認真的寫了這句話;reviewer 像嚴格的指導教授,專挑沒有根據、推論過頭的地方。你是委託研究的老闆,只要把問題講清楚。
這裡說的「agent(代理)」,指的是會自己決定下一步、會動手使用工具的 AI 程式,跟只會一問一答的聊天機器人不一樣。如果 agent、context window 這些詞還不熟,可以先看我們整理的 老闆級 AI 用語對照表,五分鐘就能跟上。
項目 | Feynman AI 的答案 |
|---|---|
它是什麼 | 開源的 AI 研究代理,專門做文獻搜尋、研究綜述、引用核對 |
誰做的 | Companion 團隊(GitHub 組織 Companion-Inc),主要開發者是 Advait Paliwal |
在哪裡用 | 終端機(macOS、Linux、Windows),也能接進 Zed 這類支援 ACP 的編輯器 |
底層技術 | 開源的 Pi agent 工具包,用 TypeScript 寫成 |
用哪個 AI 模型 | 自己帶:可用 ChatGPT、Claude 訂閱登入,或填 API key,也能接 Ollama、LM Studio 等本機模型 |
要不要錢 | 軟體本身 MIT 授權免費;模型和搜尋服務的用量自己付 |
成果放哪 | 你電腦上的 outputs 資料夾,Markdown 報告加一份來源紀錄檔 |
熱度 | GitHub 約 9,900 顆星、1,098 個 fork(2026-10-13 查詢) |
會有這種工具冒出來,背景很好理解:用 AI 查資料的人越來越多,但大家越來越不敢全信。微軟 AI Economy Institute 的 2026 第一季報告指出,台灣生成式 AI 使用率達 31.8%,首度擠進全球前 20;同一時間,Stack Overflow 2025 開發者調查裡,不信任 AI 輸出準確度的人有 46%,比信任的 33% 還多,高度信任的只剩 3%。用得多、信得少,Feynman 想解的就是中間那段「怎麼讓 AI 給的研究結果查得到出處」。
Feynman 算終端機嗎?先分清楚終端機和跑在裡面的程式
不算。終端機是一個讓你打字下指令的視窗,Feynman 是在這個視窗裡執行的一支程式。
把終端機想成 LINE 的聊天視窗就好懂了:LINE 視窗本身不會幫你訂便當,你得加一個訂餐機器人,在視窗裡跟它講話。終端機也一樣,它只是個打字的地方;你在裡面輸入 feynman,才是把 Feynman 這個研究機器人叫出來。
大家會誤會,多半是因為它的啟動畫面。Feynman 一打開會用方塊字畫出一個超大的 feynman 字樣,左邊列出目前用的模型和四個 agent,右邊列出研究指令,看起來就像一個全新的軟體介面。下面這張是官方 GitHub 提供的執行畫面:
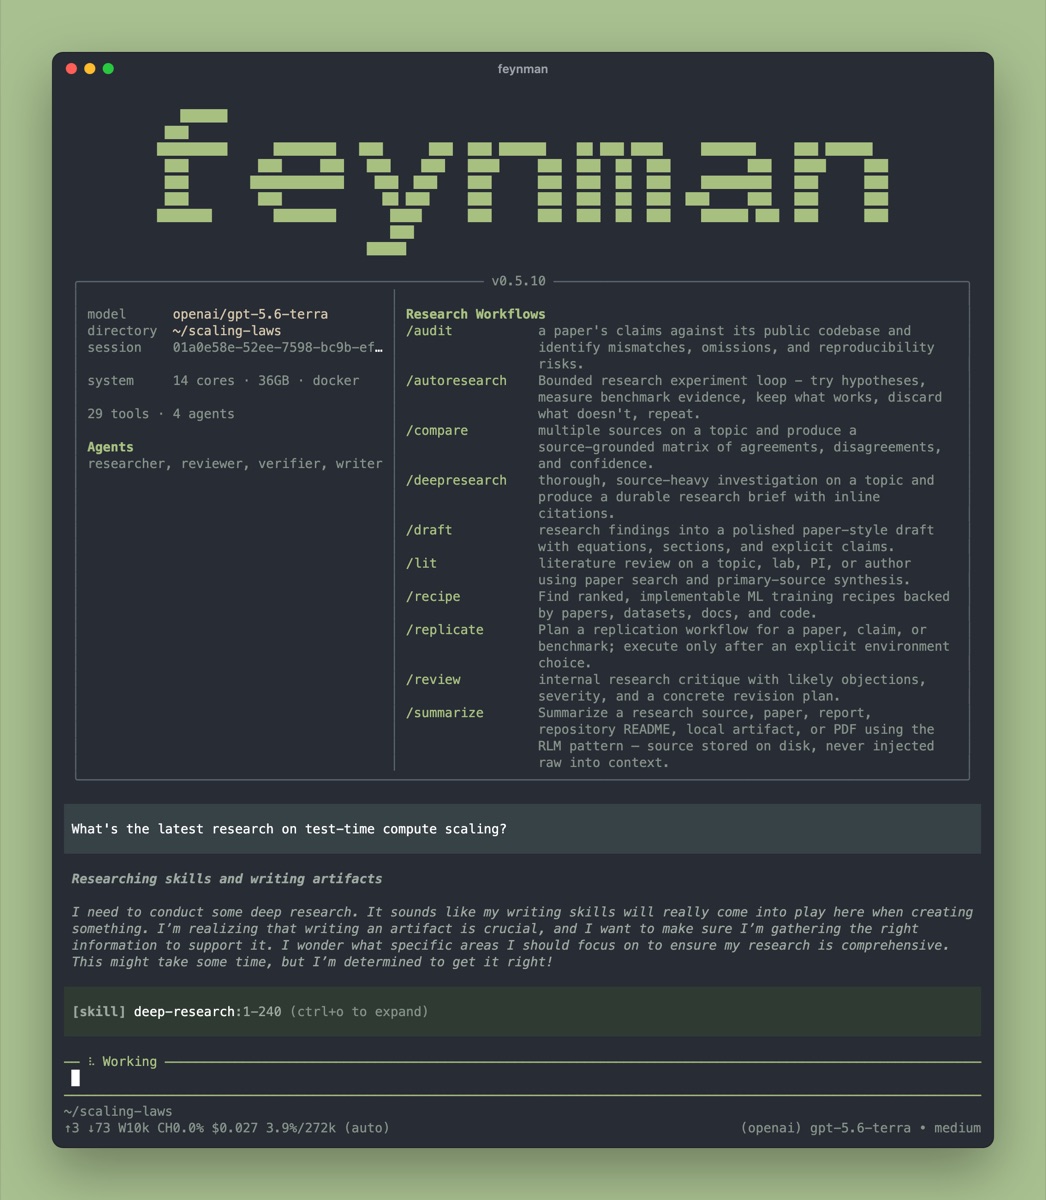
圖片來源:Companion-Inc/feynman 官方 README。視窗外框是一般的 macOS 終端機,框裡面整個畫面都是 Feynman 畫出來的。
終端機、Shell、CLI 工具、AI agent CLI 這幾個詞常常混著講,用一張表分清楚:
名詞 | 白話是什麼 | 常見例子 |
|---|---|---|
終端機(Terminal) | 打字下指令的視窗 | macOS 終端機、iTerm2、Windows Terminal |
Shell | 視窗裡負責看懂你打的指令的程式 | Bash、zsh、PowerShell |
CLI 工具 | 在終端機裡執行、用指令操作的軟體 | git、npm、curl |
AI agent CLI | 在終端機裡執行、會自己讀檔案、跑指令、做完一整件事的 AI 程式 | Claude Code、Codex CLI、OpenCode、Feynman |
Feynman 屬於最後一類。它底層用的是開源的 Pi agent 工具包,Pi 本身就是一個寫程式用的 AI agent CLI,在 GitHub 上有超過 11 萬顆星。Feynman 的做法像是拿一台現成的車子底盤,改裝成研究專用車:加上查論文的工具、研究用的指令和四個分工好的 agent。官方文件也寫明它「跑在原版的 Pi 上」,從 v0.5.0 起不再修改 Pi 本身。
為什麼這類 AI 工具都愛住在終端機?因為 agent 要真的動手做事:開檔案、寫檔案、跑指令、下載資料。終端機是電腦上最直接的操作入口,不用另外做一套網頁介面就能做到這些事。代價是對不熟指令的人門檻比較高,這也是本篇後面會把安裝步驟一行一行寫出來的原因。想看這類 agent 框架怎麼選,可以接著讀 AI Agent 框架選型指南。
讓 AI 把一大堆原始資料讀完,交出一份整理好、有結構的文件,這個模式其實不限於論文。我們做過的 Meeting King 用的就是同一個思路,只是場景換成會議:自動錄 Google Meet,再用 AI 產出結構化的會議記錄,省掉會後聽錄音、打逐字稿的時間。如果你公司也有「資料很多、要有人整理成報告」的工作,可以跟我們聊聊。
Feynman 怎麼做研究?researcher、writer、verifier、reviewer 的分工
先講結論:它把一份研究拆成規劃、找資料、寫草稿、加引用、審查、交付幾個步驟,每一步的中間產物都寫成檔案,所以事後查得到每一句話是從哪裡來的。
以最常用的 /deepresearch(深度研究)為例,官方文件寫的流程是這樣:
最值得看的是它會依題目大小決定要派幾個 researcher。窄題由主 agent 自己查,比較型題目派 2 個,大範圍的題目派 3 到 6 個平行跑。這跟真實研究團隊一樣:小題目一個人做就好,大題目才拆給好幾個人。
角色 | 像現實中的誰 | 負責什麼 | 官方設定的特點 |
|---|---|---|---|
researcher | 跑圖書館的研究助理 | 每個問題用 2 到 4 組不同說法搜尋,合併結果,寫出至少 5 筆來源的證據表 | 高思考強度;可用網路搜尋、學術資料庫、Hugging Face 工具 |
writer | 執筆的人 | 只用拿到的研究筆記寫成有摘要、分段、待解問題的草稿 | 沒有搜尋工具,也不自己加引用,避免「邊寫邊編」 |
verifier | 核對腳註的編輯 | 每個說法後面補引用編號,打開每個網址確認存在、而且真的支持那句話;論文用兩個索引交叉比對作者與年份 | 對不上的說法刪掉或改成待辦,並列出被刪掉的內容 |
reviewer | 挑毛病的指導教授 | 找沒根據的說法、邏輯漏洞、只靠單一來源的關鍵結論、信心講過頭的地方 | 問題分 FATAL、MAJOR、MINOR 三級,FATAL 修完才交件 |
writer 被刻意設計成沒有搜尋工具,這個細節很關鍵。AI 最常出事的地方,就是寫到一半「順手補一個看起來很合理的來源」。把寫作和找資料拆開,寫的人只能用已經查到的東西,引用則交給另一個角色獨立核對。
為什麼要這麼麻煩?因為 AI 編造引用已經是學術圈的現實問題。2026 年 2 月一篇分析 GhostCite 測了 13 個大型語言模型,請它們產生論文引用,每個模型都會編造,比例從 14.23% 到 94.93% 不等;同一篇研究也發現 AI 與資安領域會議論文裡,含無效引用的論文在 2025 年增加了 80.9%。另一份刊在《The Lancet》的分析更直接:檢查約 250 萬篇 PubMed 論文後,2026 年前七週每 277 篇就有 1 篇引用了根本不存在的論文,2025 年是每 458 篇 1 篇,2023 年是每 2,828 篇 1 篇。
verifier 和 reviewer 就是針對這個問題放進流程的兩道關卡。如果你平常用 ChatGPT、Claude 查資料,同樣的檢查邏輯也能自己做,我們在 AI 幻覺驗證 SOP 整理了五個步驟。
Feynman 的十個研究指令能做什麼?從文獻綜述到論文對程式碼稽核
最常用的是三個:`/deepresearch` 做深度研究、`/lit` 做文獻綜述、`/summarize` 摘要一份文件。其他七個偏向研究人員和機器學習工程師的需求。每個指令都能在 Feynman 裡用斜線輸入,也能直接在終端機打 feynman lit "題目" 這種寫法。
指令 | 白話在做什麼 | 誰最常用到 |
|---|---|---|
/deepresearch | 針對一個問題做完整調查,產出附引用的研究簡報 | 要做技術背景調查的 PM、工程主管、研究生 |
/lit | 文獻綜述:整理學界哪裡有共識、哪裡在吵、哪些還沒答案;輸入實驗室或作者名字時會整理他們的研究脈絡 | 研究生、寫論文相關研究章節的人 |
/summarize | 摘要一篇論文、報告、README 或 PDF,原文存在硬碟而不是整篇塞給模型 | 所有人 |
/compare | 比較多個來源,做成「誰同意、誰反對、信心多高」的矩陣 | 要做技術選型的團隊 |
/review | 像審稿人一樣挑毛病,附嚴重程度與修改計畫 | 要投稿或交報告前的人 |
/audit | 把論文宣稱的結果和它公開的程式碼對照,找出不一致 | 要引用某篇論文成果的工程師 |
/replicate | 規劃怎麼複現一篇論文,要你明確選好執行環境後才會動手 | 機器學習工程師 |
/recipe | 找出可以實作的模型訓練做法,依成效和可行性排序 | 機器學習工程師 |
/draft | 把研究結果寫成論文格式的草稿 | 研究人員 |
/autoresearch | 針對一個基準測試反覆做實驗,留下有效的做法 | 進階研究人員 |
資料來源方面,官方 README 列出它會查 alphaXiv、Semantic Scholar、OpenAlex、arXiv、PubMed、Europe PMC、bioRxiv、medRxiv、Crossref、一般網路和 Hugging Face,也能讀你本機的 PDF 和文件。OpenAlex 和 Semantic Scholar 可以另外申請免費的 API key,避免跟大家擠共用的流量上限。
產出方面,每次研究都會在 outputs 資料夾留下研究計畫、草稿、加了引用的版本和最終報告,外加一份 .provenance.md。provenance 可以想成食品的產銷履歷:哪天做的、查了哪些來源、哪些採用、哪些被剔除、驗證狀態是什麼,全部寫在裡面。報告交出去之後,有人質疑某個數字,你可以直接翻履歷。
這裡要特別提醒一件事:網路上不少介紹還寫著 Feynman 有「論文排序(PaperRank)」和本機的 science workbench 網頁介面。這兩個功能在 2026-09-23 的 v0.4.0 版已經移除,官方在 release notes 的說法是要專心在研究流程本身,而且用關鍵字起頭的排序會漏掉經典論文,改由 /lit 和 /deepresearch 負責搜尋與排序。看第三方文章時,記得對照官方最新版本。
Feynman 跟 ChatGPT、Claude Code 差在哪?一張表看懂定位
差在「專心做哪件事」和「成果放在哪」:ChatGPT 是什麼都能聊的通用助理,Claude Code 專心讀懂和修改程式碼,Feynman 專心做有引用、查得到出處的研究。
比較項目 | ChatGPT(網頁、App) | Claude Code | Feynman |
|---|---|---|---|
主要用途 | 通用對話,也有深度研究功能 | 讀懂並修改程式碼專案 | 查論文、寫綜述、核對引用 |
在哪裡用 | 瀏覽器、手機 App | 終端機、IDE | 終端機、支援 ACP 的編輯器 |
主要資料來源 | 網路搜尋 | 你的程式碼庫,需要時上網 | 學術資料庫、網路、本機 PDF |
成果長什麼樣 | 對話裡的回答或報告 | 改好的程式碼與 commit | 存在資料夾裡的 Markdown 報告與來源紀錄 |
用哪家模型 | OpenAI 的模型 | Anthropic 的 Claude 模型 | 自己選,雲端或本機都可以 |
授權與費用 | 商業訂閱 | 商業產品,需 Claude 訂閱或 API | MIT 開源,軟體免費,模型用量自付 |
上手門檻 | 最低 | 中,要會基本終端機操作 | 中,要會基本終端機操作與模型設定 |
如果你只是想快速知道某件事,ChatGPT 這類工具還是最省事;Feynman 的價值出現在「這份研究要交給別人看、別人會追問出處」的時候。它把每一步都落成檔案,換來的是可以稽核,代價是比較慢、比較耗 token。
它也能跟寫程式的 agent 一起用。官方提供一個「只裝技能(skills only)」的版本,不裝 Feynman 本體,只把它的研究技能和指令複製到 Codex 的 ~/.codex/skills/feynman,或 OpenCode 的 .opencode/skills/feynman,讓你在原本的 coding agent 裡也能叫出研究流程。技能包是什麼概念,可以參考我們寫過的 Claude Skills 完整指南;Codex 和 Claude Code 的差別在 Codex vs Claude Code 實測;開源 coding agent 的自架評估則在 OpenCode + Aider 實戰。
一般人和企業能拿 Feynman 做什麼?適合與不適合的情境
適合「要讀很多資料、而且結論要能交代出處」的工作;要即時答案、或需要專業背書的決策,就不適合單獨交給它。
情境 | 適不適合 | 原因 |
|---|---|---|
研究生寫文獻回顧 | 很適合 | /lit 直接對應,能整理共識、分歧和待解問題 |
工程團隊評估一個新模型或新技術 | 適合 | /compare 產出比較矩陣,/audit 能對照論文和公開程式碼 |
產品經理做技術背景調查 | 可以試 | /deepresearch 產出附引用的簡報,但題目要問得夠具體 |
業務查客戶的產業動態 | 普通 | 學術資料庫幫助不大,一般 AI 搜尋工具更快 |
醫療、法律、財務決策 | 不適合單獨使用 | 引用核對只能確認來源存在並支持那句話,證據夠不夠仍要專業判斷 |
處理公司機密文件 | 要先設計 | 雲端模型、網路搜尋都會把內容送出電腦,除非全部換成本機方案 |
對一般上班族來說,如果需求是整理會議、讀報告、做筆記,Notion AI 或 NotebookLM 這類工具會更順手,我們在 AI 筆記術實測比較過。Feynman 的主場在研究和工程。
我們的判斷是:大多數中小企業不需要裝 Feynman,但很值得把它的流程設計抄回自己的 AI 工作流。它示範了三件事:找資料和寫報告分開做、引用交給獨立角色核對、每一步都留檔可以追。這三件事放在企業內部的知識庫、市場調查、投標資料準備,一樣成立。很多公司導入 AI 卡關,問題出在流程裡少了一個「回頭查證」的關卡,工具挑哪一個反而影響不大。
這也是我們自己在做的事。我們公司內部每天有 20+ 個 AI 流程在跑,寫這篇文章的流程本身就是類似的分工:一個階段負責查官方文件和數據,寫完後再用驗證腳本和檢查清單把關,每個外部引用都要確認發布時間。內部怎麼安排這些流程,寫在 恆遠內部 AI 工作流揭密。如果你想讓 AI 讀的是公司自己的文件,而不是公開論文,要看的會是 企業 RAG 知識庫架構。
怎麼開始試 Feynman?安裝、連接模型、跑第一個研究題目
三步:安裝、執行 `feynman setup` 連接模型、丟一個研究題目。以下指令都來自官方說明文件,目前最新版是 2026-10-13 發布的 v0.5.43。
第一步:安裝
macOS 或 Linux 在終端機貼上這行:
curl -fsSL https://feynman.is/install | bashWindows 用 PowerShell:
irm https://feynman.is/install.ps1 | iex官方安裝程式會下載一個自帶 Node.js 執行環境的完整套件,並在安裝前驗證檔案的 SHA-256 雜湊值,所以電腦上不用先裝 Node.js。Windows 另外要裝 Git for Windows,因為 Feynman 用 Bash 執行指令,沒有 Bash 的話研究跑到第一個指令就會失敗。已經有 Node.js 22.22 以上的人,也可以用 npm install -g @companion-ai/feynman 安裝。
公司電腦要注意一點:「把網路上的腳本直接丟給 bash 執行」是很多資安政策會擋的做法。比較穩的方式是鎖定版本號安裝,讓每台電腦裝到同一版:
curl -fsSL https://feynman.is/install | bash -s -- 0.5.43
feynman --version
第二步:連接 AI 模型
feynman setup設定精靈會問你要怎麼連模型:用 OAuth 登入現有的 ChatGPT、Claude Max、Copilot 訂閱,或填 OpenAI、Anthropic 等服務的 API key。登入資料存在 ~/.feynman/agent/auth.json,只有你的帳號讀得到;如果把 key 設在環境變數裡,就不會寫進硬碟。
想讓模型跑在自己電腦上,可以接 LM Studio、LiteLLM、Ollama 或 vLLM。官方給的 Ollama 範例設定如下:
API mode: openai-completions
Base URL: http://localhost:11434/v1
Send Authorization header: No
API key / resolver: local
Model id(s): llama3.1:8b
官方也老實寫了:太小的本機模型常常會跳過多步驟的研究流程,直接在對話裡回一段話,不寫任何檔案;Ollama 預設的上下文長度只有幾千 token,也會造成同樣的狀況,要用 OLLAMA_CONTEXT_LENGTH=65536 ollama serve 這類設定拉大。本機模型要挑多大、硬體要準備多少,可以參考 Gemma 4 自架 vs 雲端評估。
第三步:跑第一個研究題目
mkdir my-research && cd my-research
feynman lit "RAG 評估方法"
feynman deepresearch "小型語言模型在客服場景的準確度研究"
feynman doctor
建議先開一個空資料夾再跑,因為 Feynman 會在目前資料夾寫入 outputs 和 papers。跑完打開 outputs 裡的 Markdown 檔就是報告,旁邊的 .provenance.md 是來源紀錄。遇到登入、模型或環境問題,feynman doctor 會檢查一輪並列出下一步該做什麼。
順手做:關掉遙測
Feynman 預設會傳匿名使用數據到 PostHog,內容包含執行的指令、工作流程名稱、用了哪些工具、token 數量,以及錯誤訊息和 stack trace。官方寫明不會傳你的提問、模型輸出、論文內容和工具參數,但錯誤訊息裡可能帶到專案裡的檔案路徑。在意的話,在 shell 設定檔加一行就能關掉,feynman status 可以確認目前狀態:
export FEYNMAN_TELEMETRY=off
# 或使用通用的關閉方式
export DO_NOT_TRACK=1步驟 | 指令 | 完成後會看到什麼 |
|---|---|---|
安裝 | curl -fsSL https://feynman.is/install | bash | ~/.local/bin 多了 feynman 指令 |
確認版本 | feynman --version | 印出版本號,例如 0.5.43 |
連接模型 | feynman setup | 選好登入方式,自動挑一個建議的研究模型 |
跑研究 | feynman lit "題目" | outputs 資料夾出現報告與 .provenance.md |
健康檢查 | feynman doctor | 列出登入、模型、搜尋設定的狀態與建議 |
關閉遙測 | export FEYNMAN_TELEMETRY=off | feynman status 顯示遙測已關閉 |
用 Feynman 前要知道的五個風險:資料、遙測、成本、改版速度、證據
先講結論:開源只代表軟體免費、程式碼看得到,私密和正確都還要你自己設計。一篇 2026-09-03 的獨立評論 wavect.io 的 Feynman 評估講得很直接,Feynman 預設情況下不會讓研究自動變得免費、私密或正確,「完全本機」只是一種可以做到的設定,大部分預設流程都會連網。
風險 | 實際情況 | 怎麼處理 |
|---|---|---|
資料送出電腦 | 雲端模型、網路搜尋、alphaXiv、學術資料庫查詢都會把你的問題送到外部服務 | 機密題目改用本機模型,搜尋只用不需外傳內容的來源,先畫清楚資料流向 |
遙測 | 預設開啟,送指令名稱、token 數、錯誤訊息,錯誤裡可能含檔案路徑 | 設 FEYNMAN_TELEMETRY=off,用 feynman status 確認 |
成本 | 軟體免費,模型 token 和付費搜尋自付;官方 release notes 提到 /lit 曾因單次查詢回傳資料過大,吃掉數百萬 token,v0.5.4 後才調整 | 先用小題目量一次花費,在模型服務後台設用量上限 |
改版很快 | 2026-10-12 到 10-13 兩天就發了 v0.5.37 到 v0.5.43 七個版本;v0.4.0 一次拿掉 workbench 等多項功能 | 公司環境鎖定版本,升級前先讀 release notes |
引用對得上,證據未必夠 | verifier 只能確認網址存在、內容支持那句話;搜尋也可能漏掉改變結論的那篇論文 | 關鍵結論由人讀原文,報告當草稿看待 |
資料外流和金鑰保管這兩件事,跟其他 AI agent 工具是同一套功課。登入資料和 API key 都放在使用者目錄底下,跟 Claude Code 讀到 .env 的風險同類,做法可以參考 別讓 Claude Code 看到你的 .env;公司層級的部署資安則在 AI agent 部署資安指南。
Stack Overflow 同一份 2025 調查裡,有 87% 的受訪者擔心 AI agent 給的資訊不準,81% 擔心資料安全與隱私。Feynman 的引用核對處理了前者的一部分,後者就要靠使用的人自己設定。一般人用 AI 時該注意的個資、幻覺、著作權問題,我們整理在 用 AI 前該知道的 5 件事。
中小企業老闆該怎麼看 Feynman 這類 AI 研究工具
跟著教學跑一次 demo 不難,難的是把它變成公司每天在用的東西。Feynman 示範的「查資料、寫報告、獨立核對、全程留檔」這條流程,要套進公司內部,通常還差一層客製:資料來源換成你的文件和系統、權限要分清楚誰能看什麼、成果要接回你們平常用的地方。少了這一層,工具就只是工程師桌上的玩具。
ℹ️我們做過這件事
順帶說一下,這篇講的分工方式,我們公司自己每天都在用:內部目前有 20+ 個 AI 流程在工作,查資料、寫初稿、交給驗證腳本把關,都是實際跑起來確認省得到時間之後才寫出來的。
例如我們做過的 Meeting King,就是讓 AI 把會議錄音整理成結構化會議記錄,跟 Feynman 把論文整理成研究報告是同一類問題。
看到這裡,如果你也在想「公司裡那些要讀一堆資料才能寫出來的報告,能不能交給 AI 先做一輪」,我們很樂意聽你聊聊現在的實際情況,一起看看哪一段最值得先動。
ℹ️我們怎麼看
AI 研究工具接下來比的會是「交得出出處」,誰的模型比較聰明反而是其次。我們預期兩三年內,企業內部用 AI 寫的報告都會被要求附上來源紀錄,就像財報要附底稿。我們選擇站在 Feynman、Claude 這些開源與現成工具的肩膀上,專心做把它們接進客戶流程的那一層,不自己重造研究代理。對中小企業老闆來說,現在不用急著裝任何研究代理,可以先問自己一個問題:公司裡哪一份定期報告,如果有人追問「這個數字哪來的」,目前答不出來?先從那一份開始補上查證流程,工具之後再挑。
想先盤點公司裡哪些流程適合交給 AI,可以從 AI 顧問服務 開始,我們會直接跟你說哪些值得做、哪些先放著。
Feynman AI 常見問題 FAQ
QFeynman AI 是終端機嗎?
不算。終端機是打字下指令的視窗,Feynman 是在終端機裡執行的一支開源 AI 研究程式。它啟動時會畫出自己的介面和 logo,所以截圖看起來像一個新軟體,外框其實還是你原本的終端機。
QFeynman 要錢嗎?
軟體本身是 MIT 開源授權,免費下載使用。要付錢的是你接上的 AI 模型和付費搜尋服務,例如 ChatGPT、Claude 訂閱或 API 用量。接本機模型可以省掉模型費用,但需要夠力的電腦,而且太小的模型常跑不完多步驟研究流程。
QFeynman 跟 ChatGPT 的深度研究有什麼不同?
兩者都會上網找資料並寫成附引用的報告。Feynman 是開源程式,模型自己選,會查 Semantic Scholar、OpenAlex、PubMed 等學術資料庫,並把研究計畫、草稿、引用版本和來源紀錄全部存成檔案,適合需要事後稽核的研究;ChatGPT 上手最簡單,適合快速了解一件事。
QFeynman 會把我的資料傳出去嗎?
會有一部分。用雲端模型或網路搜尋時,你的問題會送到那些服務;遙測預設開啟,會送指令名稱、token 數和錯誤訊息,官方表示不傳提問、模型輸出和論文內容。可以設定 FEYNMAN_TELEMETRY=off 或 DO_NOT_TRACK=1 關閉遙測,機密題目建議改用本機模型。
Q不會寫程式可以用 Feynman 嗎?
可以,但要願意打幾行指令。安裝、執行 feynman setup 登入模型、再輸入 feynman lit 加題目,就能拿到第一份報告。完全不想碰終端機的人,用 ChatGPT、Claude 或 NotebookLM 這類有圖形介面的工具會更輕鬆。
QFeynman 的 workbench 和 PaperRank 去哪了?
這兩個功能在 2026 年 9 月 23 日的 v0.4.0 版移除,官方表示要專注在找論文、讀論文、引用核對這條研究主線。網路上較早的介紹還會提到它們,要用的話只能安裝 0.3.49 舊版,一般使用者直接用 /lit 和 /deepresearch 即可。
AUTHOR
恆遠數位編輯團隊
想了解更多?看看我們的相關服務
相關文章
Meta 廣告自動化怎麼做?8 條 AI 工作流程拆解:觸發、門檻、人工核准一次畫清楚
Meta Ads MCP 能力邊界總整理:AI 能接手 Meta 廣告到什麼程度,還需要用瀏覽器操作廣告管理員嗎?
Workload Identity Federation 是什麼?呼叫 Claude API 不用固定 API key 的白話指南
Claude 新創計畫怎麼申請?免費一年 Team、US$1,000 API 額度與資格條款整理
reverse-skill 是什麼?看懂這個 3.9 萬星 AI 資安技能路由包,與背後的逆向、滲透測試基本功
留言(0)
尚無留言,成為第一個留言的人吧!