Jev 繁體中文分類實測:221 筆台灣客服訊息、94.1% 正確率、confidence 門檻怎麼畫,以及哪些句型會騙過它
Jev 模型對繁體中文客服訊息的分類正確率是 94.1%:我們拿 221 筆台灣客服訊息、四個類別(詢價、進度、系統問題、一般詢問)實測 jev-1.13.0,221 筆全跑完花了 0.0054 美元,從台北打過去每筆中位數 611 毫秒。把 confidence 門檻設在 0.7,92% 的訊息可以交給程式自動分流,那 92% 的正確率是 97.1%。緊急度三級評分完全命中 84.2%、差一級以內 100%;抱怨偵測 14 筆全抓到,但門檻 0.7 時會多抓 7.7% 的非抱怨。
這篇的起點是上一篇Jev 模型技術解析留下的一個問號:官方文件明講英文最準、CJK 能處理但不等同,要台灣團隊自己拿資料測。我們自己的客服分流流程正好是它的教科書用法,所以我們在 9 月 22 日直接註冊、寫了資料集跟腳本,把它對著台灣客戶會講的話跑一輪。這篇只講跑出來的東西:哪些對、哪些錯、錯的長什麼樣、門檻該畫在哪、改 criteria 有沒有用、塞無關內容會不會拖累,所有數字都有截圖,腳本跟資料集也開在 GitHub 上讓你自己重跑。
先把整個實驗的結論放在一張表裡,後面每一節再展開:
問題 | 實測答案 |
|---|---|
分類正確率(四類) | 94.1%,13 筆錯;其中 5 筆是我們自己的標籤有爭議,真正明顯錯的 8 筆 |
confidence 能不能當門檻 | 能。0.9 以上的 191 筆正確率 98.4%;0.6 以下 11 筆錯了 6 筆 |
門檻 0.7 會怎樣 | 92% 自動處理、正確率 97.1%,8% 進人工,跟我們原本 LLM 版的 8 到 12% 人工比例接近 |
緊急度(Score 三級) | 完全命中 84.2%,差一級以內 100%;系統問題幾乎全被判成「今天內」或「現在」 |
抱怨偵測(Noul) | 14 筆真抱怨全抓到;門檻 0.7 時誤抓 16 筆,砍價、催進度、系統壞掉都被當抱怨 |
改 criteria 有沒有用 | 有,把台灣講法與邊界寫進去從 94.1% 到 96.4% |
塞 300 token 無關簽名檔 | 原始 criteria 幾乎不受影響;改良版 criteria 反而掉到 91.4%,原因在下面 |
英文與簡體混入 | 9 筆全對,confidence 都在 0.96 以上 |
延遲與成本 | 台北到 API 中位數 611 毫秒、最慢 768 毫秒;221 筆共 127,987 個輸入 token、0.0054 美元 |
我們測了什麼:221 筆仿真台灣客服訊息與四個問題
先講資料從哪來,因為這決定了數字能不能信。我們不把客戶寫的內容送進第三方 API,所以資料集是我們自己寫的:221 筆仿真訊息,句型取自官網真實進件的寫法、LINE 上客戶會打的口語、PTT 與 Dcard 常見問法,每一筆都先由人標好三個答案,再送給模型。刻意混進去的邊角案例有這幾種:
- 錯字與口語:「想詢價 chatGTP 企業版報價」「老闆叫我問一下做官網要多少」
- 簡體與英文:「请问进度如何」「Hi, any update on the staging deployment?」
- 超短訊息:「想了解」「收到 謝謝」「三天沒回我訊息了」
- 垃圾與測試:「親愛的用戶,您的帳戶已中獎」「[內部測試] 診斷同步問題,可直接刪除」
- 客氣但其實在生氣:「已經兩週沒收到進度回報了,可以更新一下嗎」
類別 | 筆數 | 例子 |
|---|---|---|
quote 詢價 | 61 | 「不好意思想請問一下,官網改版報價怎麼算」「上次報的那個價可以再便宜一點嗎 老闆說太貴」 |
progress 進度 | 50 | 「上週說這週可以看初版,什麼時候能看」「三天沒回我訊息了」 |
bug 系統問題 | 50 | 「後台登入不進去,顯示 500」「客戶說結帳頁面跳錯誤,付不了錢!!」 |
general 一般詢問 | 60 | 「想了解」「你們有做過醫療業的案子嗎」「親愛的用戶,您的帳戶已中獎」 |
每筆訊息一次呼叫問三題,跟我們分流流程的三層對應:business_type 用 Choice 選四類、urgency 用 Score 分三級(這週內、今天內、現在就要)、is_complaint 用 Noul 判有沒有抱怨或想換廠商的訊號。criteria 第一版故意寫得像一般工程師會寫的樣子,每個選項一句定義,沒有特別針對台灣講法調整,這樣才知道「不特別優化」的基準在哪。模型固定用 jev-1.13.0 而非 jev-latest,門檻要綁版本。整套腳本、資料集與原始回應都在 sheepskill 的 drafts/jev-zh-tw-benchmark 目錄,你可以換成自己的訊息重跑。
順帶講一下我們為什麼在意這題。我們自己每天在用的 CRM SalesKing,AI 讀完 LINE 對話後判斷客戶處在哪個銷售階段、生成追蹤計畫,「判斷銷售階段」跟這裡的 business_type 是同一種形狀的題目:選項固定、答案要能讓後面的自動化直接用。這一層判斷如果能用 Jev 這種便宜又能設門檻的模型做,整條流程的成本結構會不一樣。如果你手上的系統也有這種「先判斷、再動作」的節點,可以直接跟我們聊,我們可以先幫你看哪幾題適合這樣拆。
分類結果 94.1%:錯的 13 筆長什麼樣
先給答案:221 筆錯 13 筆,四類裡詢價最穩(61 筆只錯 1 筆),進度最容易被判成一般詢問(4 筆)。下面是跑完 report 的原始終端機畫面,混淆矩陣、confidence 區間、門檻曲線、高信心答錯全在同一張圖上:
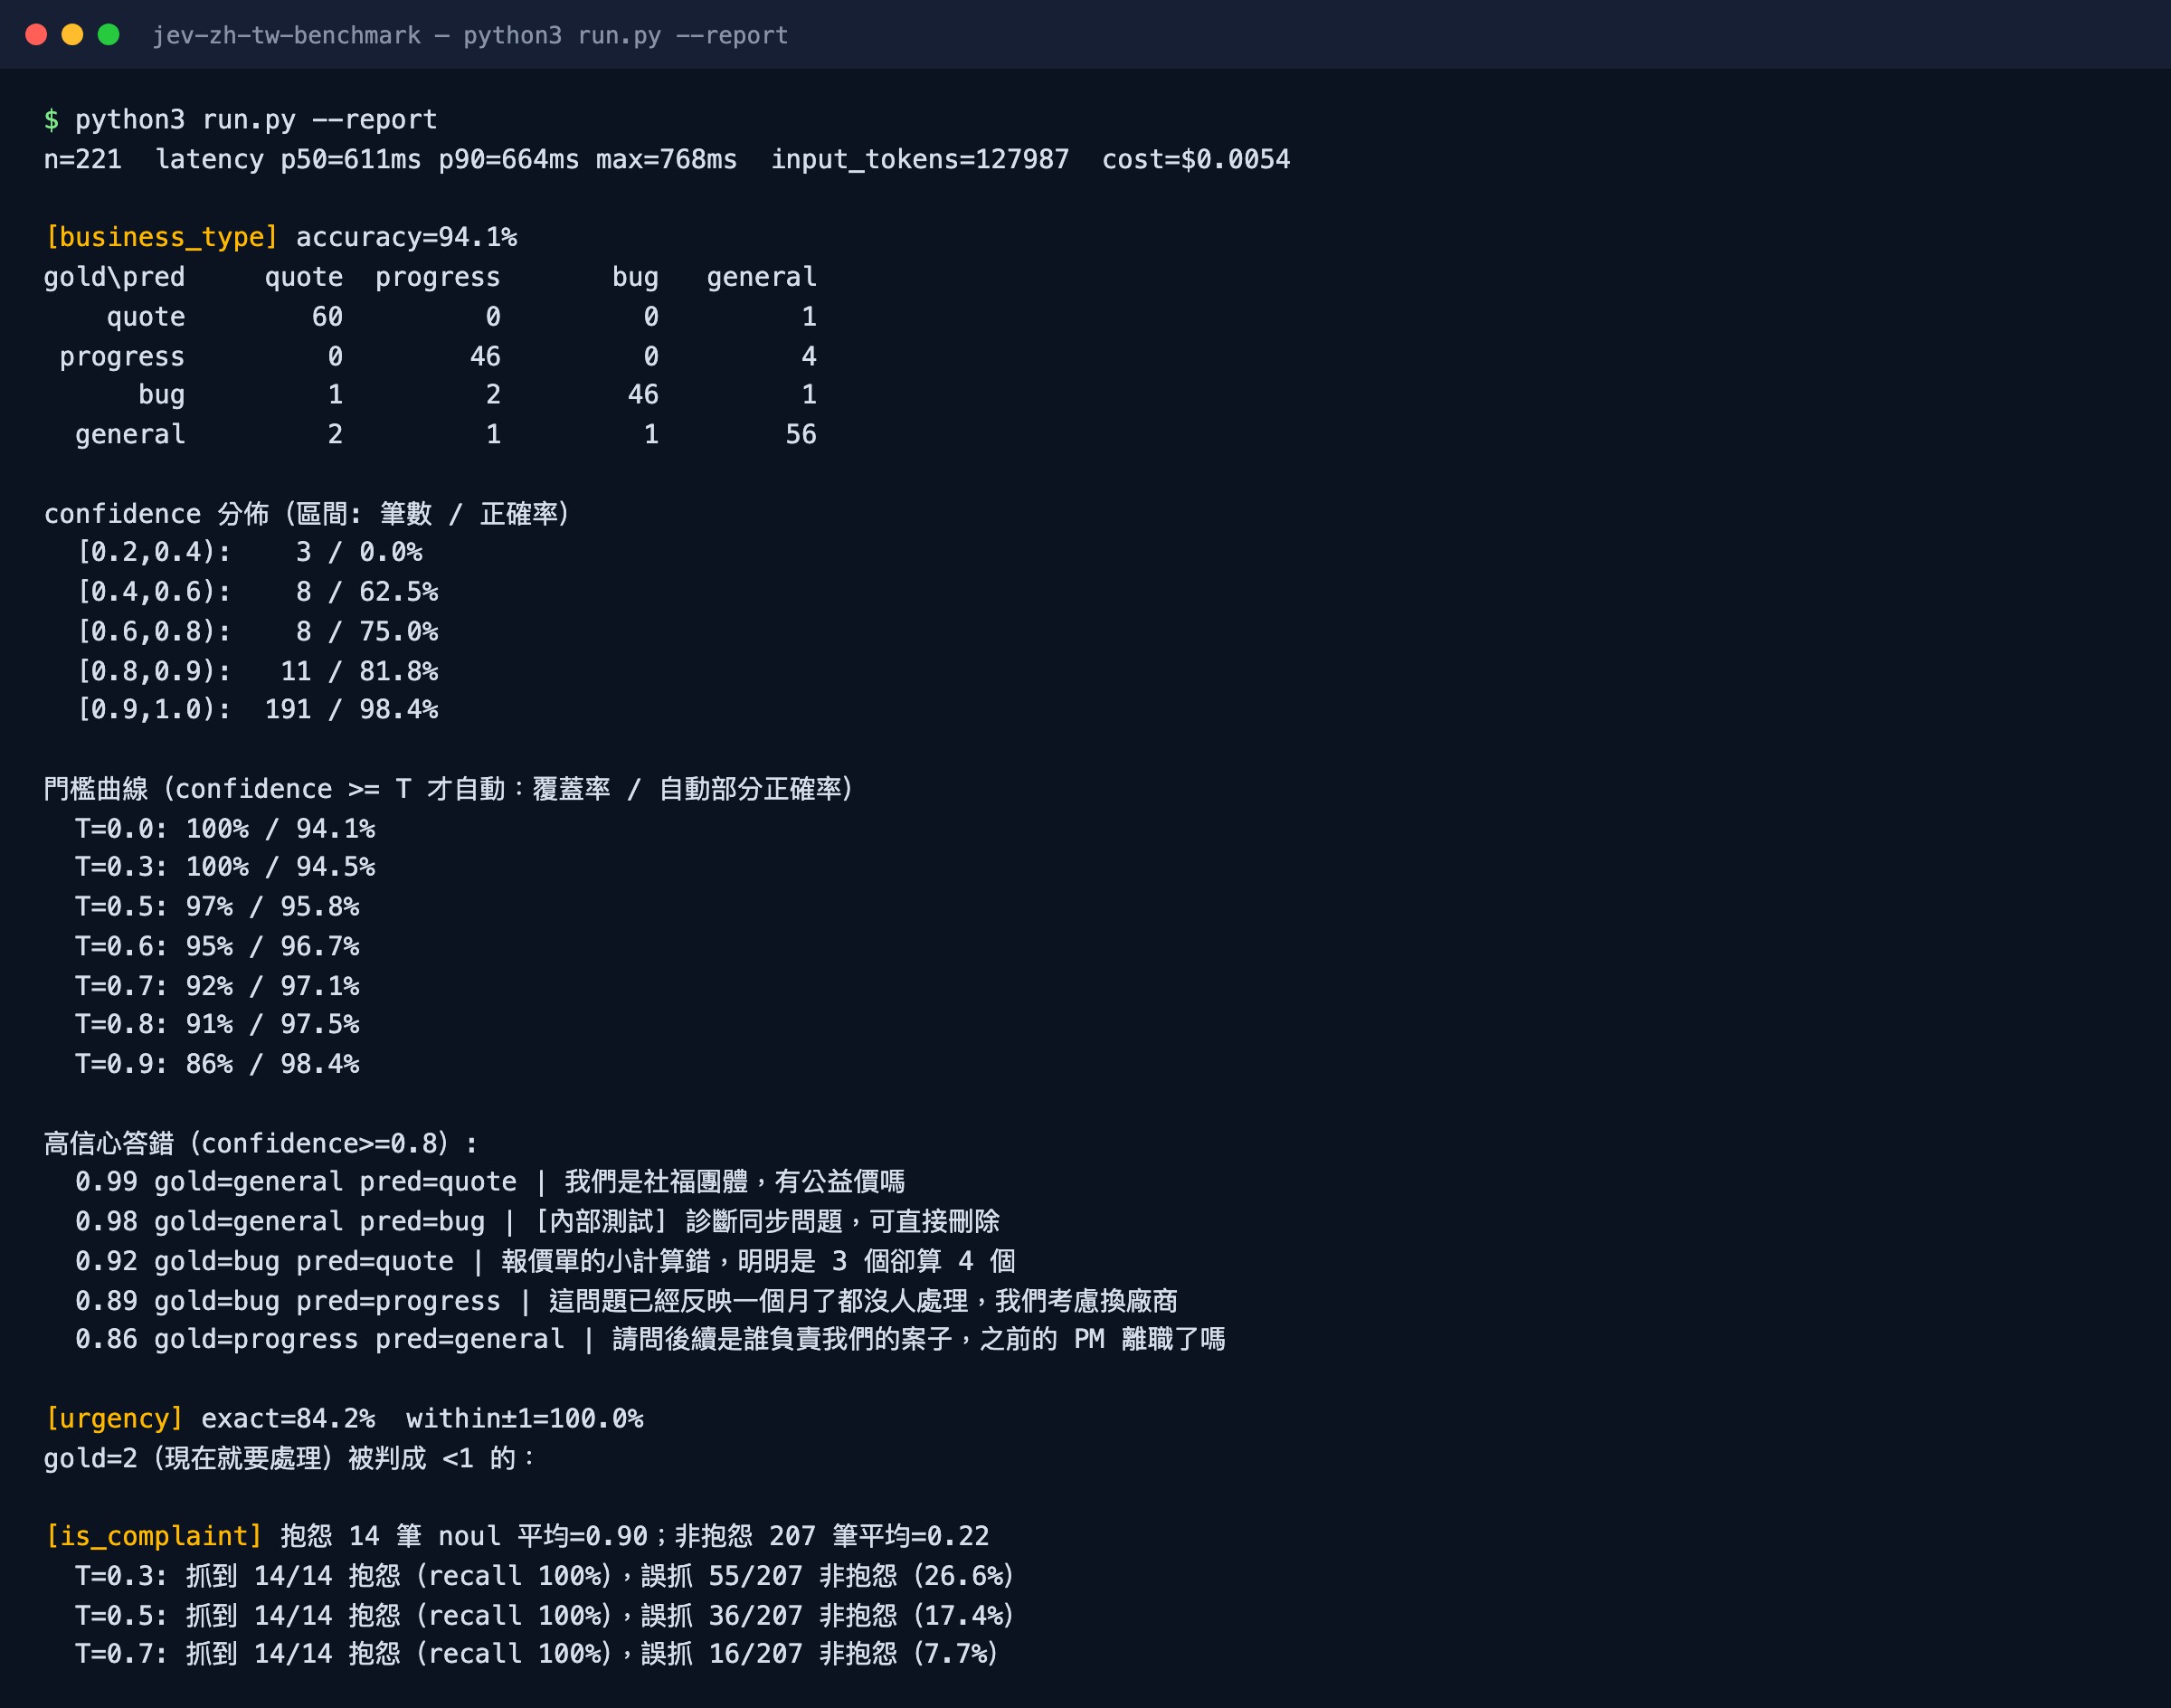
實際類別 \ 模型判成 | quote | progress | bug | general |
|---|---|---|---|---|
quote(61) | 60 | 0 | 0 | 1 |
progress(50) | 0 | 46 | 0 | 4 |
bug(50) | 1 | 2 | 46 | 1 |
general(60) | 2 | 1 | 1 | 56 |
13 筆錯誤逐筆看過之後,可以分成三種。第一種是我們的標籤本身有爭議,5 筆:「我們是社福團體,有公益價嗎」我們標一般詢問,模型以 0.99 的信心判詢價,事後看模型的判斷比較合理;「報價單的小計算錯,明明是 3 個卻算 4 個」我們標系統問題,模型判詢價,兩邊都說得通;「想請問一下秒發報價跟秒簽差在哪」「驗收會議可以排這週五嗎」「請問合約上寫的 60 天是從簽約日還是付款日算」都是類別邊界上的句子。把這 5 筆扣掉,明顯錯的是 8 筆,實際正確率接近 96%。
剩下的 8 筆分兩種,一種是模型的問題,一種是資料的問題。
第二種是模型讀字面、沒讀情境,3 筆:「這問題已經反映一個月了都沒人處理,我們考慮換廠商」被判成進度(信心 0.89),因為句子裡有「一個月」「沒人處理」這種時間與催促的字,模型沒有推出「問題」指的是系統問題;「每次都要修好幾天,你們有 SLA 嗎」「備份有在跑嗎?我看最後一次是上個月」也是同一類,句子裡沒有「壞掉」「錯誤」這種詞,模型就不往 bug 走。這正是官方弱點頁第一條「字面解讀」的樣子:它回答你寫的問題,不猜你的意思。
第三種是資料本身在騙它,2 筆:「[內部測試] 診斷同步問題,可直接刪除」被判成 bug(信心 0.98),因為「診斷同步問題」怎麼看都像系統問題;「請問後續是誰負責我們的案子,之前的 PM 離職了嗎」被判一般詢問,這句在真實流程裡屬於進行中案子的溝通,但單看句子確實像在問公司資訊。這兩筆的解法都在 criteria 上,下面會用第二版 criteria 證明。
信心分數真的能當門檻嗎:0.9 以上 98.4%,0.6 以下錯一半
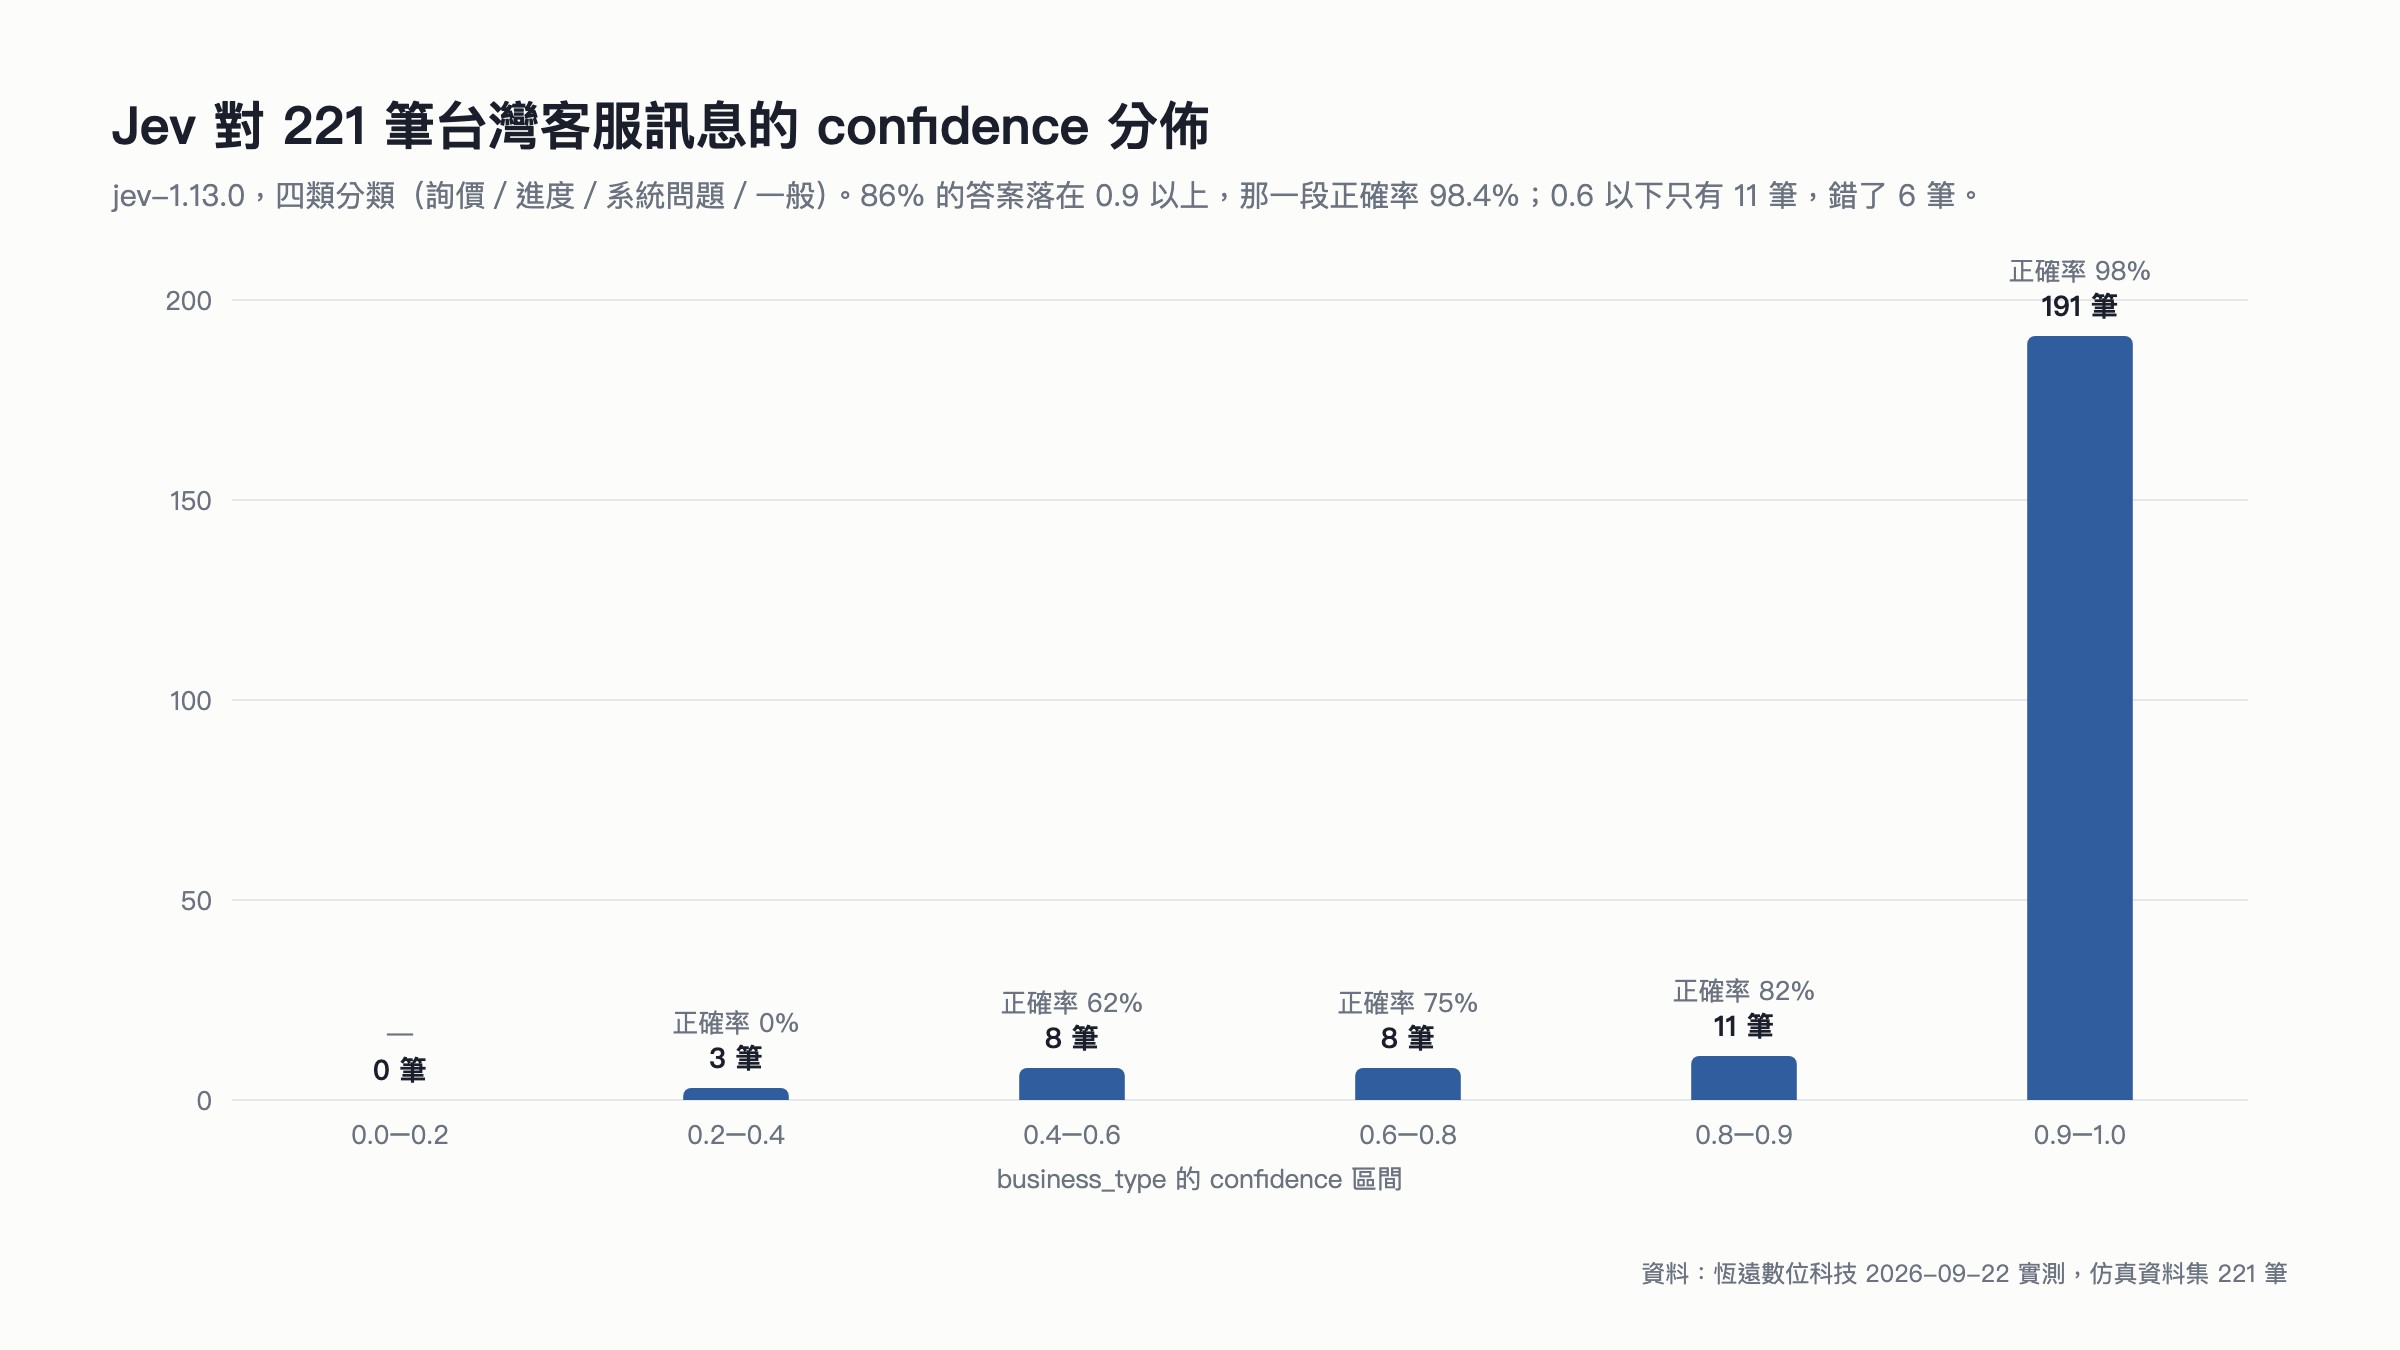
結論是可以,而且分佈很乾淨。221 筆裡 191 筆(86%)的 confidence 落在 0.9 以上,那一段正確率 98.4%;0.6 以下只有 11 筆,錯了 6 筆。中間幾乎沒有東西。這跟paddo.dev 對 9,081 筆電商配對的實測看到的雙峰形狀一致:模型要嘛很確定,要嘛明講不確定,很少給你 0.5 這種讓人難辦的數字。
把門檻 T 從 0 掃到 0.9,覆蓋率跟正確率的交換長這樣:
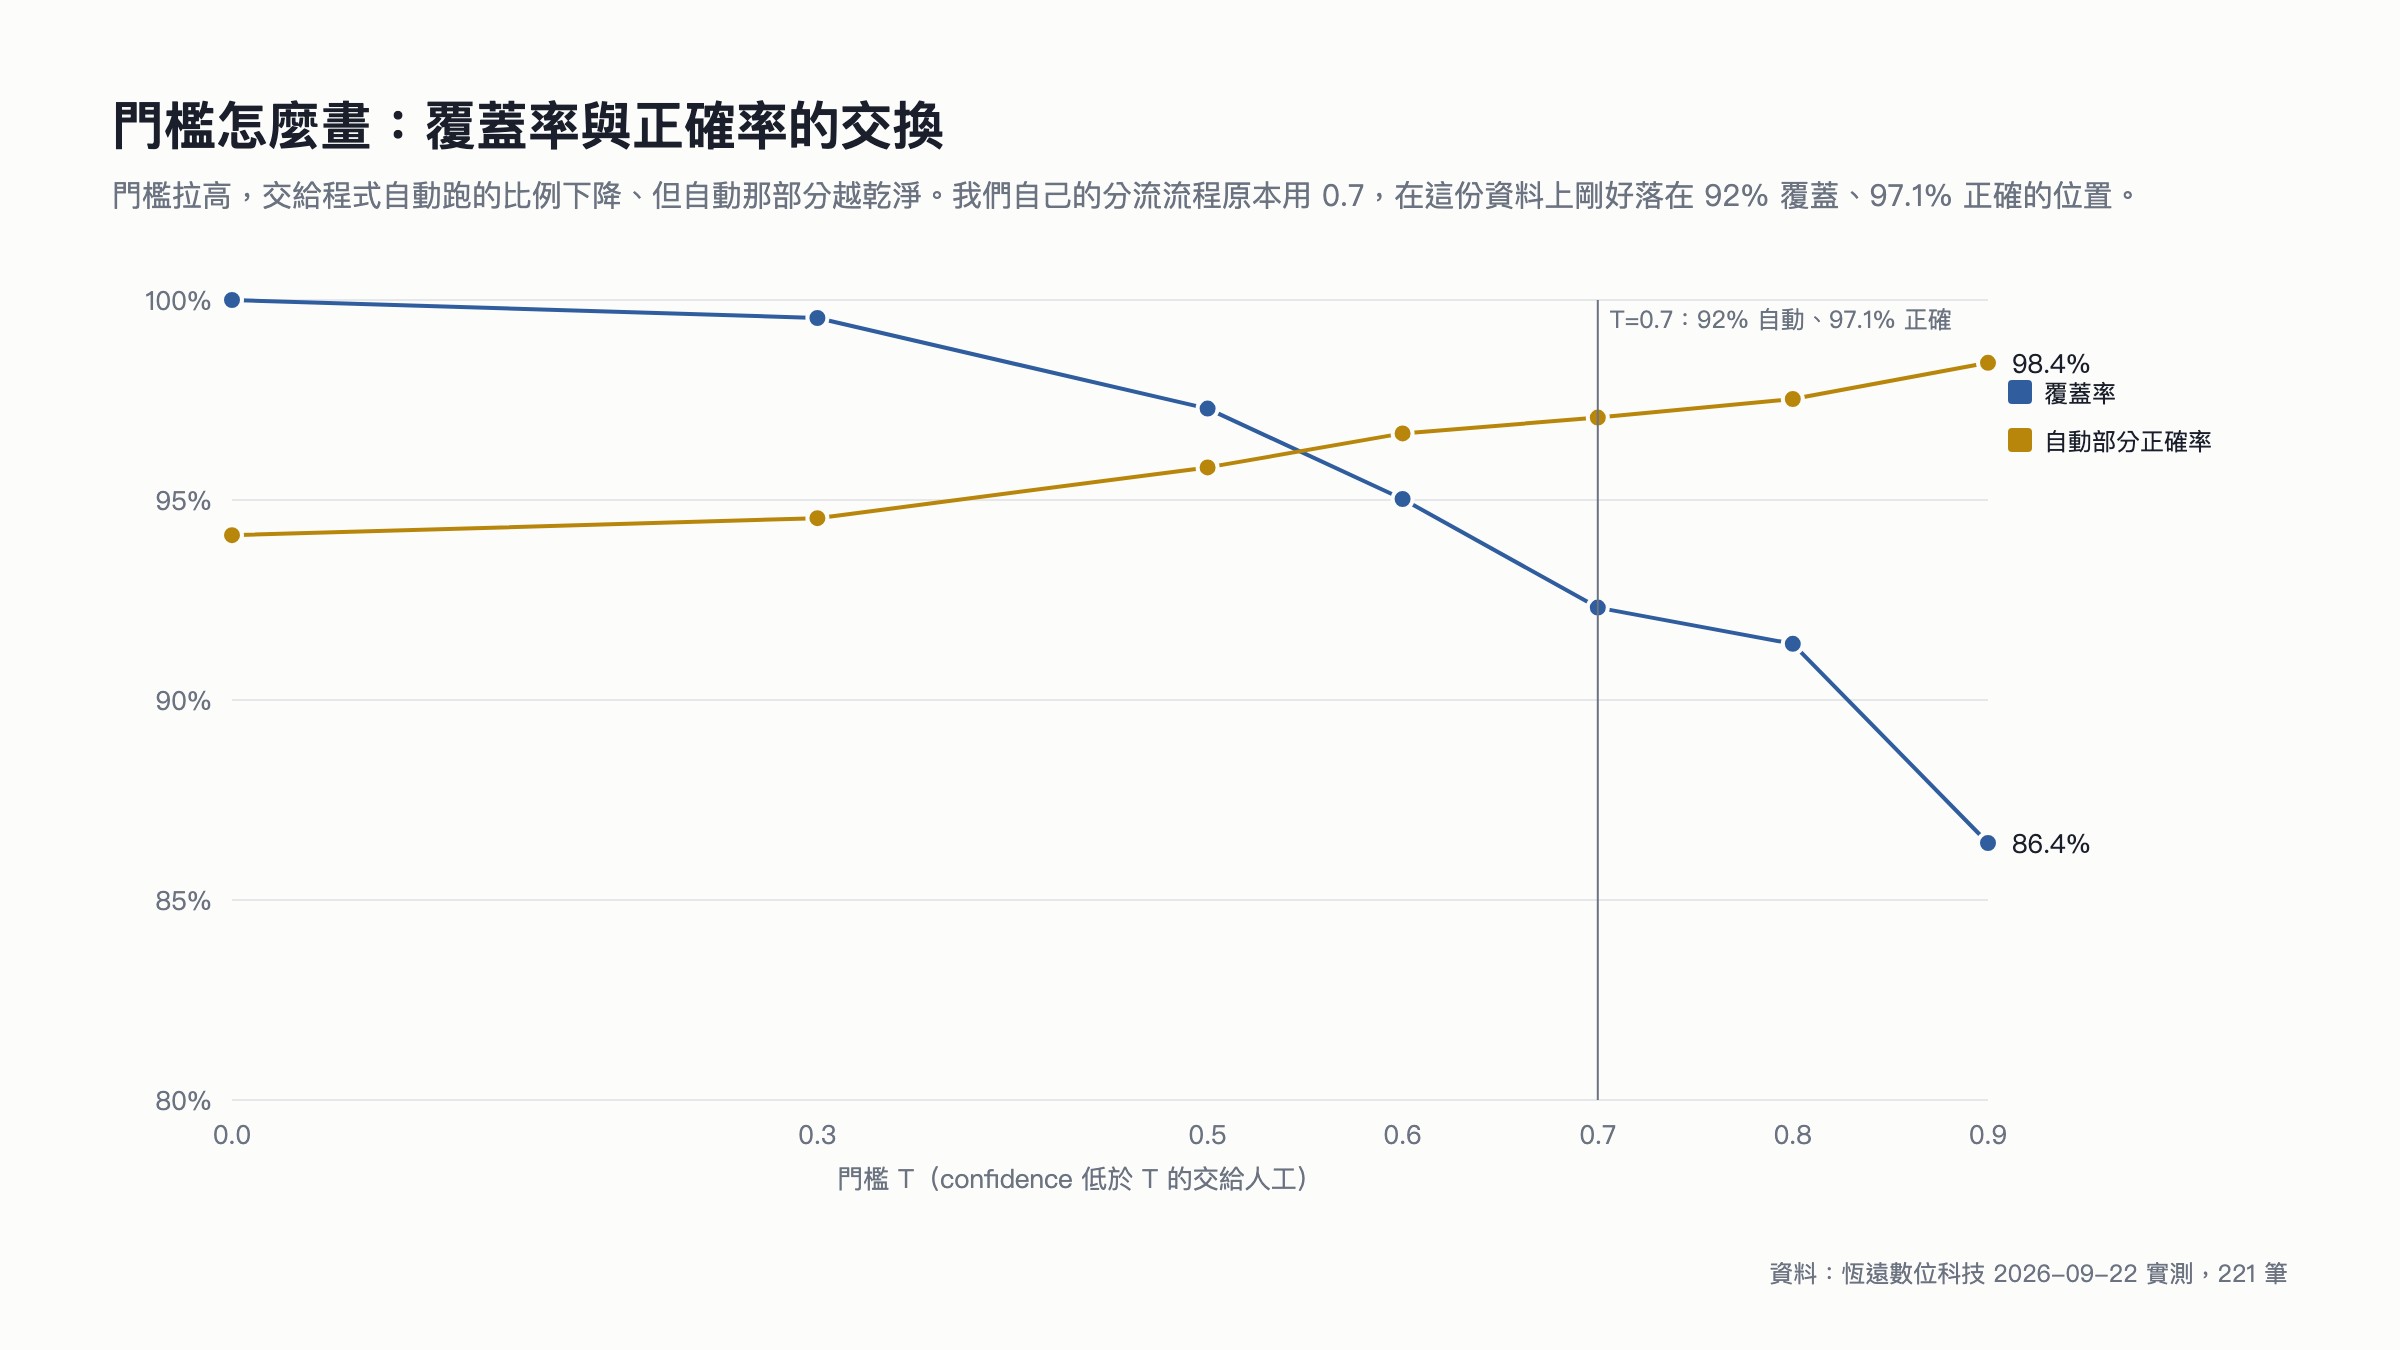
門檻 T | 自動處理比例 | 自動部分正確率 | 進人工比例 |
|---|---|---|---|
0.5 | 97% | 95.8% | 3% |
0.6 | 95% | 96.7% | 5% |
0.7 | 92% | 97.1% | 8% |
0.8 | 91% | 97.5% | 9% |
0.9 | 86% | 98.4% | 14% |
我們原本的 LLM 版分流用 0.7 當人工複審線,實務上 8 到 12% 的信進人工。在這份資料上,Jev 的 0.7 剛好落在 92% 自動、8% 人工,數字對得上,但這是巧合,理由在技術解析那篇講過:LLM 的 confidence 是它在 JSON 裡自報的,Jev 的是從機率分佈算出來的,兩者是不同的量,能對上是因為兩邊的資料都剛好在這個位置有一個自然的斷點。換成你的資料,門檻要重新從曲線上讀。
門檻擋不住的 5 筆
高信心答錯的 5 筆值得單獨講,因為它們是門檻擋不住的。信心 0.99 的「公益價」與 0.98 的「內部測試」前面說過,一筆是標籤爭議、一筆是資料在騙它;0.92 的「報價單小計算錯」是類別邊界;0.89 的「考慮換廠商」是字面解讀;0.86 的「PM 離職了嗎」是缺情境。五筆裡沒有一筆是「模型完全看不懂中文」。這個結論對台灣團隊很重要:繁體中文的問題出在 criteria 有沒有把台灣人的講法寫進去,並非模型讀不懂繁體字。
緊急度與抱怨偵測:Score 與 Noul 在中文上的表現
緊急度:偏向往上判一級,對客服反而安全
先講緊急度。三級 Score 完全命中 84.2%,差一級以內 100%,沒有任何一筆「現在就要處理」被判成「這週內」。錯的 35 筆幾乎全是往上偏一級:系統問題類 50 筆裡,我們標「今天內」的有 14 筆被判成「現在」,「登入後一直被登出」給 1.63、「簡訊驗證碼收不到」給 1.66;砍價跟催進度的訊息也偏高,「我們有拿到另一家的報價比你們低兩成」我們標「這週內」,模型給 0.84。這個偏差方向對客服流程反而安全,寧可多急一級,也別把真的急的當不急。
實際 \ 模型 | 0 這週內 | 1 今天內 | 2 現在 |
|---|---|---|---|
0 這週內(154) | 136 | 18 | 0 |
1 今天內(49) | 2 | 36 | 11 |
2 現在(18) | 0 | 4 | 14 |
Score 的 confidence 跟 Choice 的行為不一樣,要另外看。「後台的匯出 Excel 中文變亂碼」的 score 是 0.90、confidence 卻是 0.00,代表機率平均分在 0 跟 1 兩級之間,模型明講「我不知道這算不算急」。這種答案在程式裡的正確處理是拿 score 過門檻(例如 1.5 以上才當「現在」),confidence 低的那批送人工看一眼,官方 confidence 文件也是這樣建議:不要拿 Score 去內插精確數字,用它判「有沒有過線」。
抱怨偵測:全抓到,但砍價與催進度也會亮燈
再講抱怨偵測。14 筆我們標為抱怨的訊息,Noul 全部給 0.73 以上,最高是「這問題已經反映一個月了都沒人處理,我們考慮換廠商」的 0.99,「我要客訴,系統壞掉害我們今天損失一整天的訂單」0.97。recall 是 100%。問題在另一邊:門檻 0.7 時有 16 筆非抱怨被抓進來,砍價(「你們的報價比別家貴一倍」0.90)、催進度(「最近都沒消息,是不是卡在哪裡了」0.80)、系統壞掉(「網站變很慢,開一頁要十幾秒」0.92)、甚至「我們想換合作廠商,你們接手別人做的系統嗎」0.94,這句是新客戶想換掉別家廠商,模型讀到「換廠商」就亮燈。
Noul 門檻 | 抓到的真抱怨 | 誤抓的非抱怨 |
|---|---|---|
0.3 | 14 / 14 | 55 / 207(26.6%) |
0.5 | 14 / 14 | 36 / 207(17.4%) |
0.7 | 14 / 14 | 16 / 207(7.7%) |
回頭看我們的 instructions:「訊息中出現抱怨、失望、不耐煩,或考慮更換廠商的訊號」。砍價確實帶不耐煩、系統壞掉確實帶失望,模型照字面抓沒有錯,是我們的題目太寬。這題在流程裡的正確用法是當旗標而非動作:is_complaint 高於 0.7 只做一件事,就是讓當班主管多看一眼,不要拿它直接觸發任何自動回覆或升級。我們分流 SOP 的兩條紅線本來就是這樣設計的,合約與情緒相關的信不管模型多有把握都先 hold 給人。
改 criteria 有用嗎?塞無關內容會怎樣?兩個追加實驗
實驗一:把邊界寫進 criteria
第一個實驗:把前面錯誤分析看到的邊界寫進 criteria。第二版改了四句話:
- quote 補上「有沒有優惠或公益價」「只要是在談錢或要報價,就算這類」
- progress 補上「案子已經在進行中」「誰負責、合約天數怎麼算、資料或款項收到沒」
- bug 補上「算錯、備份或維護有疑慮、修不好」
- general 補上「測試訊息、垃圾廣告」
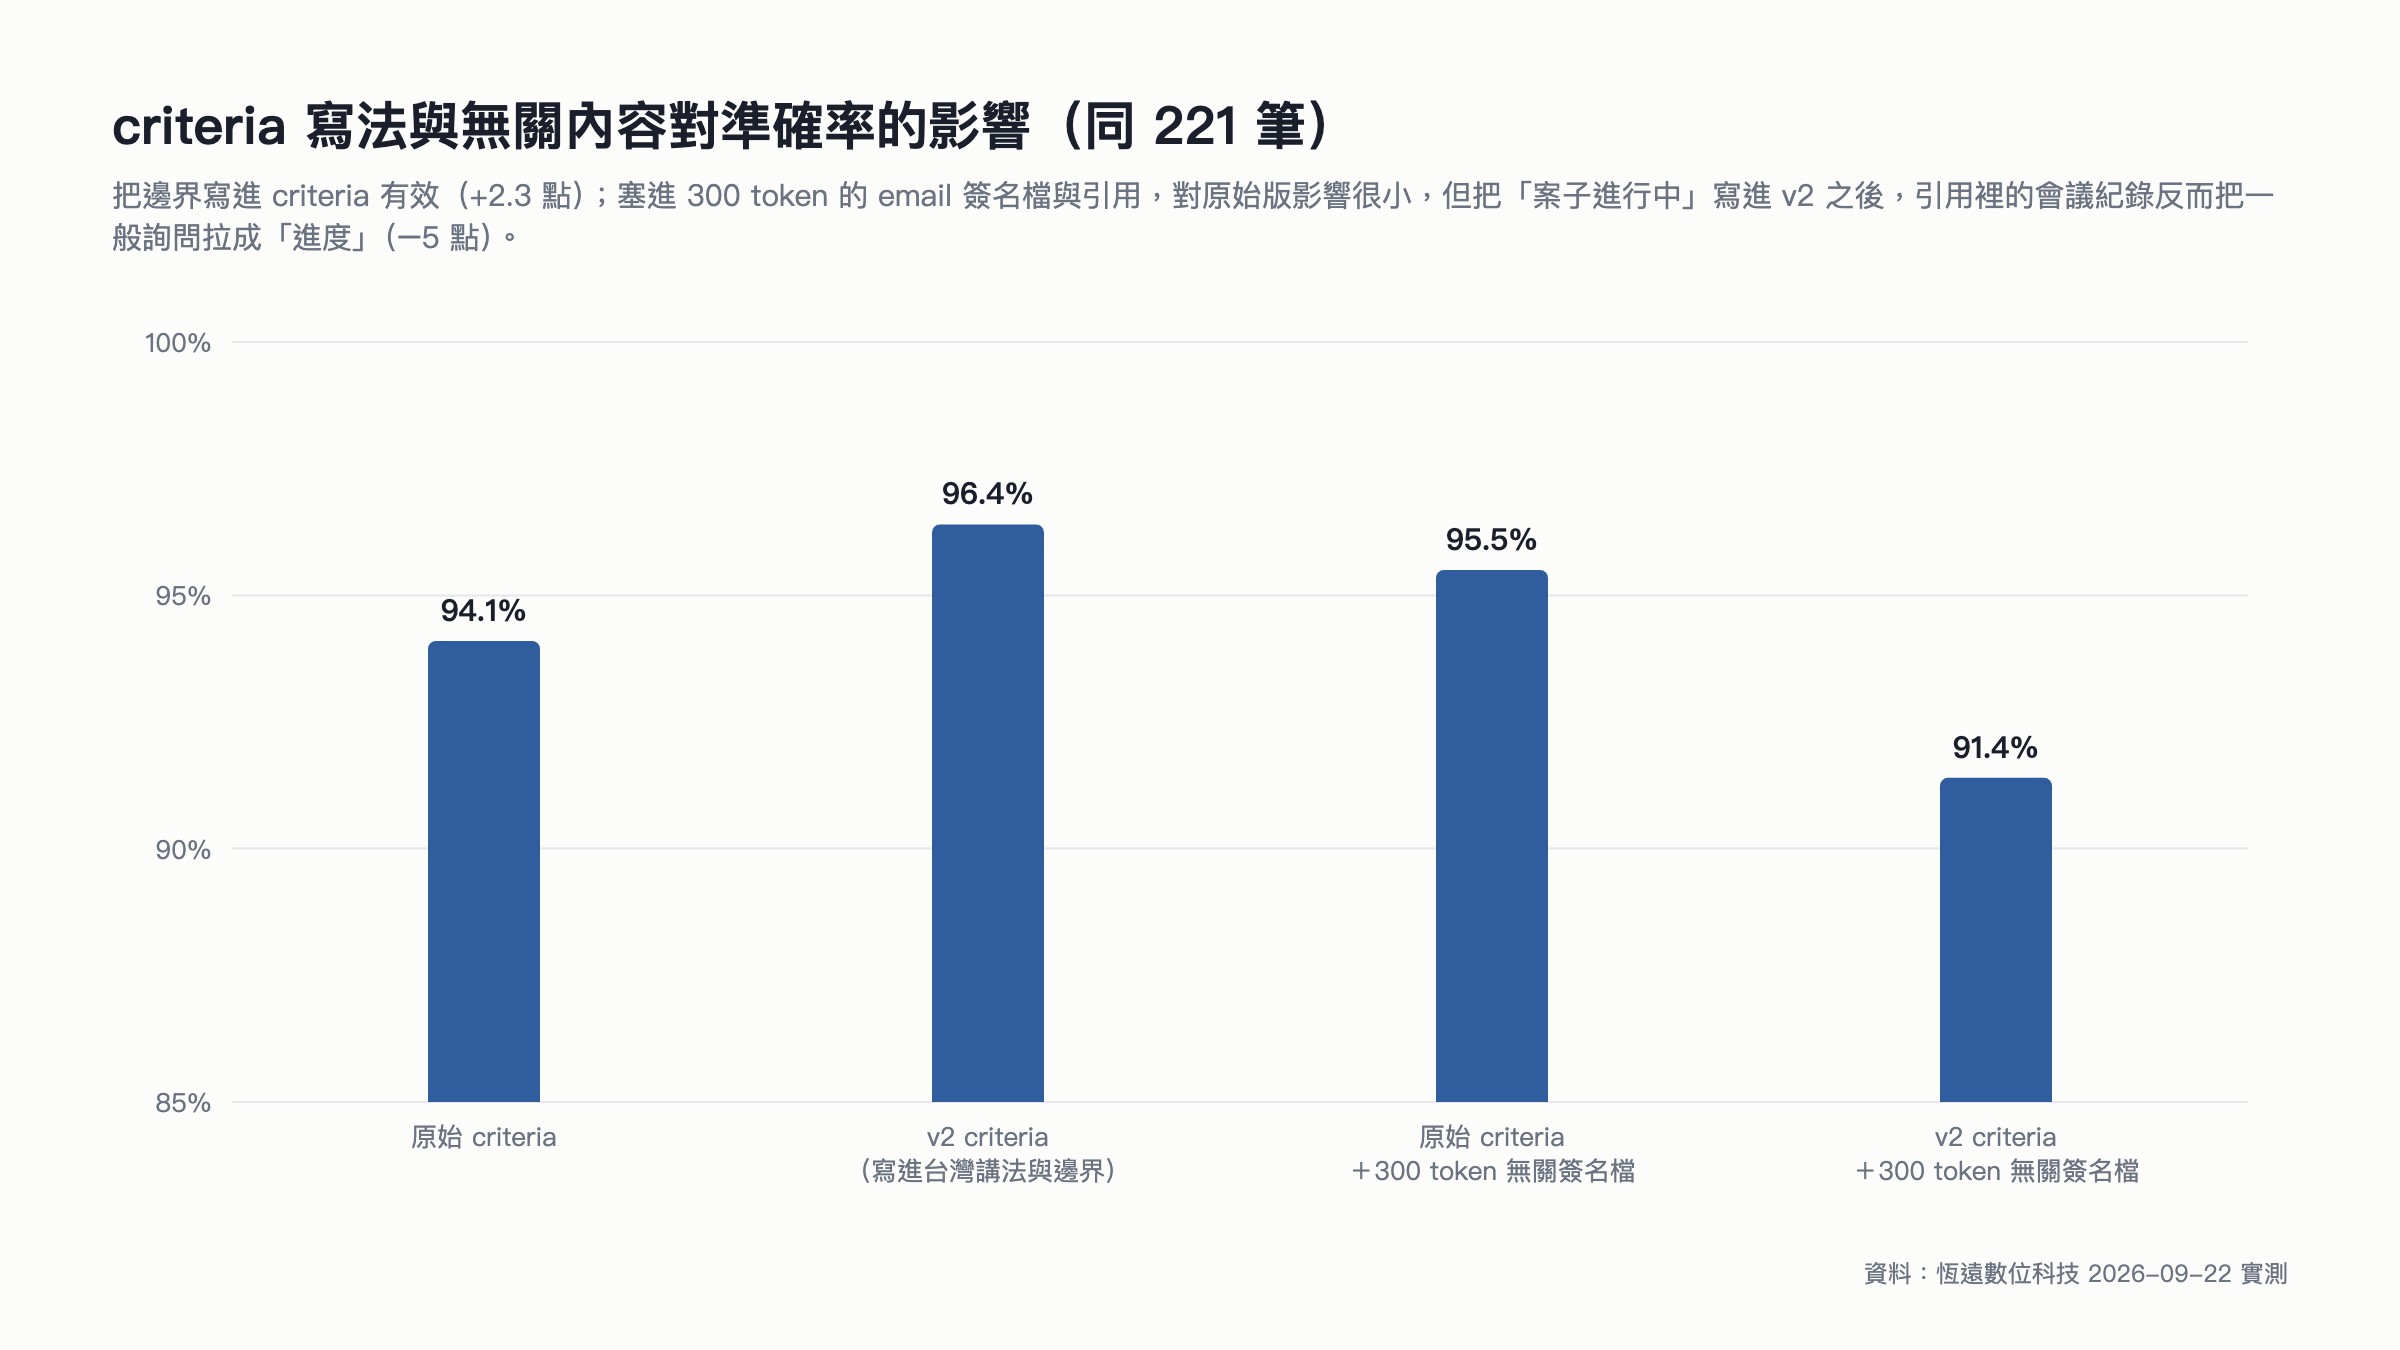
同樣 221 筆重跑,正確率從 94.1% 升到 96.4%,0.9 以上那段的正確率從 98.4% 到 99.5%。花的時間是改四句話。
實驗二:每封信前面貼 300 token 的簽名檔與引用
第二個實驗測的是官方弱點頁第五條「state 塞太多無關內容會拉低準確度」。我們在每一封訊息前面貼了一段 300 token 的 email 雜訊:Outlook 的 Original Message 表頭、一個假的專案經理簽名檔、中英文各一段機密聲明、「請考慮環境再列印」、還有一段引用的上週會議紀錄。結果出乎意料:原始 criteria 幾乎不受影響(95.5%,跟 94.1% 的差距在隨機範圍內),改良版 criteria 反而掉到 91.4%。
掉的 11 筆幾乎全是一般詢問被判成進度:「請問合約可以寄到公司地址嗎」「請問資料會放在台灣的機房嗎」「收到 謝謝」「請問下班後可以聯絡嗎」全部變成 progress。原因很清楚:第二版 progress 的定義寫了「案子已經在進行中」,而雜訊裡的引用剛好是「上週會議結論:首頁 banner 改版、下次會議 10/3」,模型看到 state 裡有進行中的案子,就把任何客氣的問句都算成進度溝通。它沒有錯,它照字面做了我們要求的事。這是弱點頁第一條與第五條疊在一起的真實樣子。
條件 | 正確率 | 0.9 以上覆蓋 / 正確率 | 輸入 token |
|---|---|---|---|
原始 criteria | 94.1% | 86% / 98.4% | 127,987 |
v2 criteria(寫進台灣講法與邊界) | 96.4% | 84% / 99.5% | 130,639 |
原始 criteria + 300 token 雜訊 | 95.5% | 81% / 98.9% | 176,165 |
v2 criteria + 300 token 雜訊 | 91.4% | 79% / 97.7% | 207,547 |
兩個實驗合起來的教訓只有一句:criteria 寫得越精準,state 就越要乾淨。把「案子進行中」這種會跟上下文互動的條件寫進去之前,程式先把簽名檔、引用、免責聲明砍掉;砍不乾淨的話,寧可 criteria 保守一點。我們在 n8n 裡接這條流程時,Jev 節點前面一定先有一個「去簽名檔與引用」的 Code 節點,這次實驗證明它值得留著。
延遲、成本、英文與簡體:規格層面的實測
延遲要先講清楚計算基準。官方說端到端 70 到 500 毫秒,我們從台北打 api.typesafe.ai,221 筆的中位數 611 毫秒、九成在 664 毫秒以內、最慢 768 毫秒,跟官方數字差的大約 100 到 200 毫秒是太平洋來回。這個數字放在客服分流裡完全沒感覺,放在使用者按下按鈕等回應的場景要自己評估。
4 個並發跑 221 筆共 44 秒,沒有碰到 429;官方速率上限是每分鐘 1,200 次請求,批次回填舊工單時才需要在意。
成本是 127,987 個輸入 token,照官方 Models 頁每百萬 0.042 美元算是 0.0054 美元,四輪實驗加起來 642,338 個 token、0.027 美元,新台幣不到一塊錢。這篇文章寫的每一個數字,總共花了不到一塊錢跑出來。
英文與簡體我們混了 9 筆進去:「请问做一个网站多少钱」「网站打不开了」「Hello, could you send me a quotation for a bilingual corporate website?」「Hi, any update on the staging deployment?」等等,9 筆全對,confidence 最低的是「Time for a new website?」的 0.96,其他都是 1.00。criteria 全部用繁體中文寫,模型跨語言對得上,這對常收到外商或中國客戶訊息的團隊是好消息。
接進客服分流時,我們會這樣設門檻
把上面所有數字收成一組可以直接用的設定。下面是一筆真實回應的長相,來自「填表單送出後沒有收到確認信,客戶以為沒送成功一直重填」這句,三題一次回:
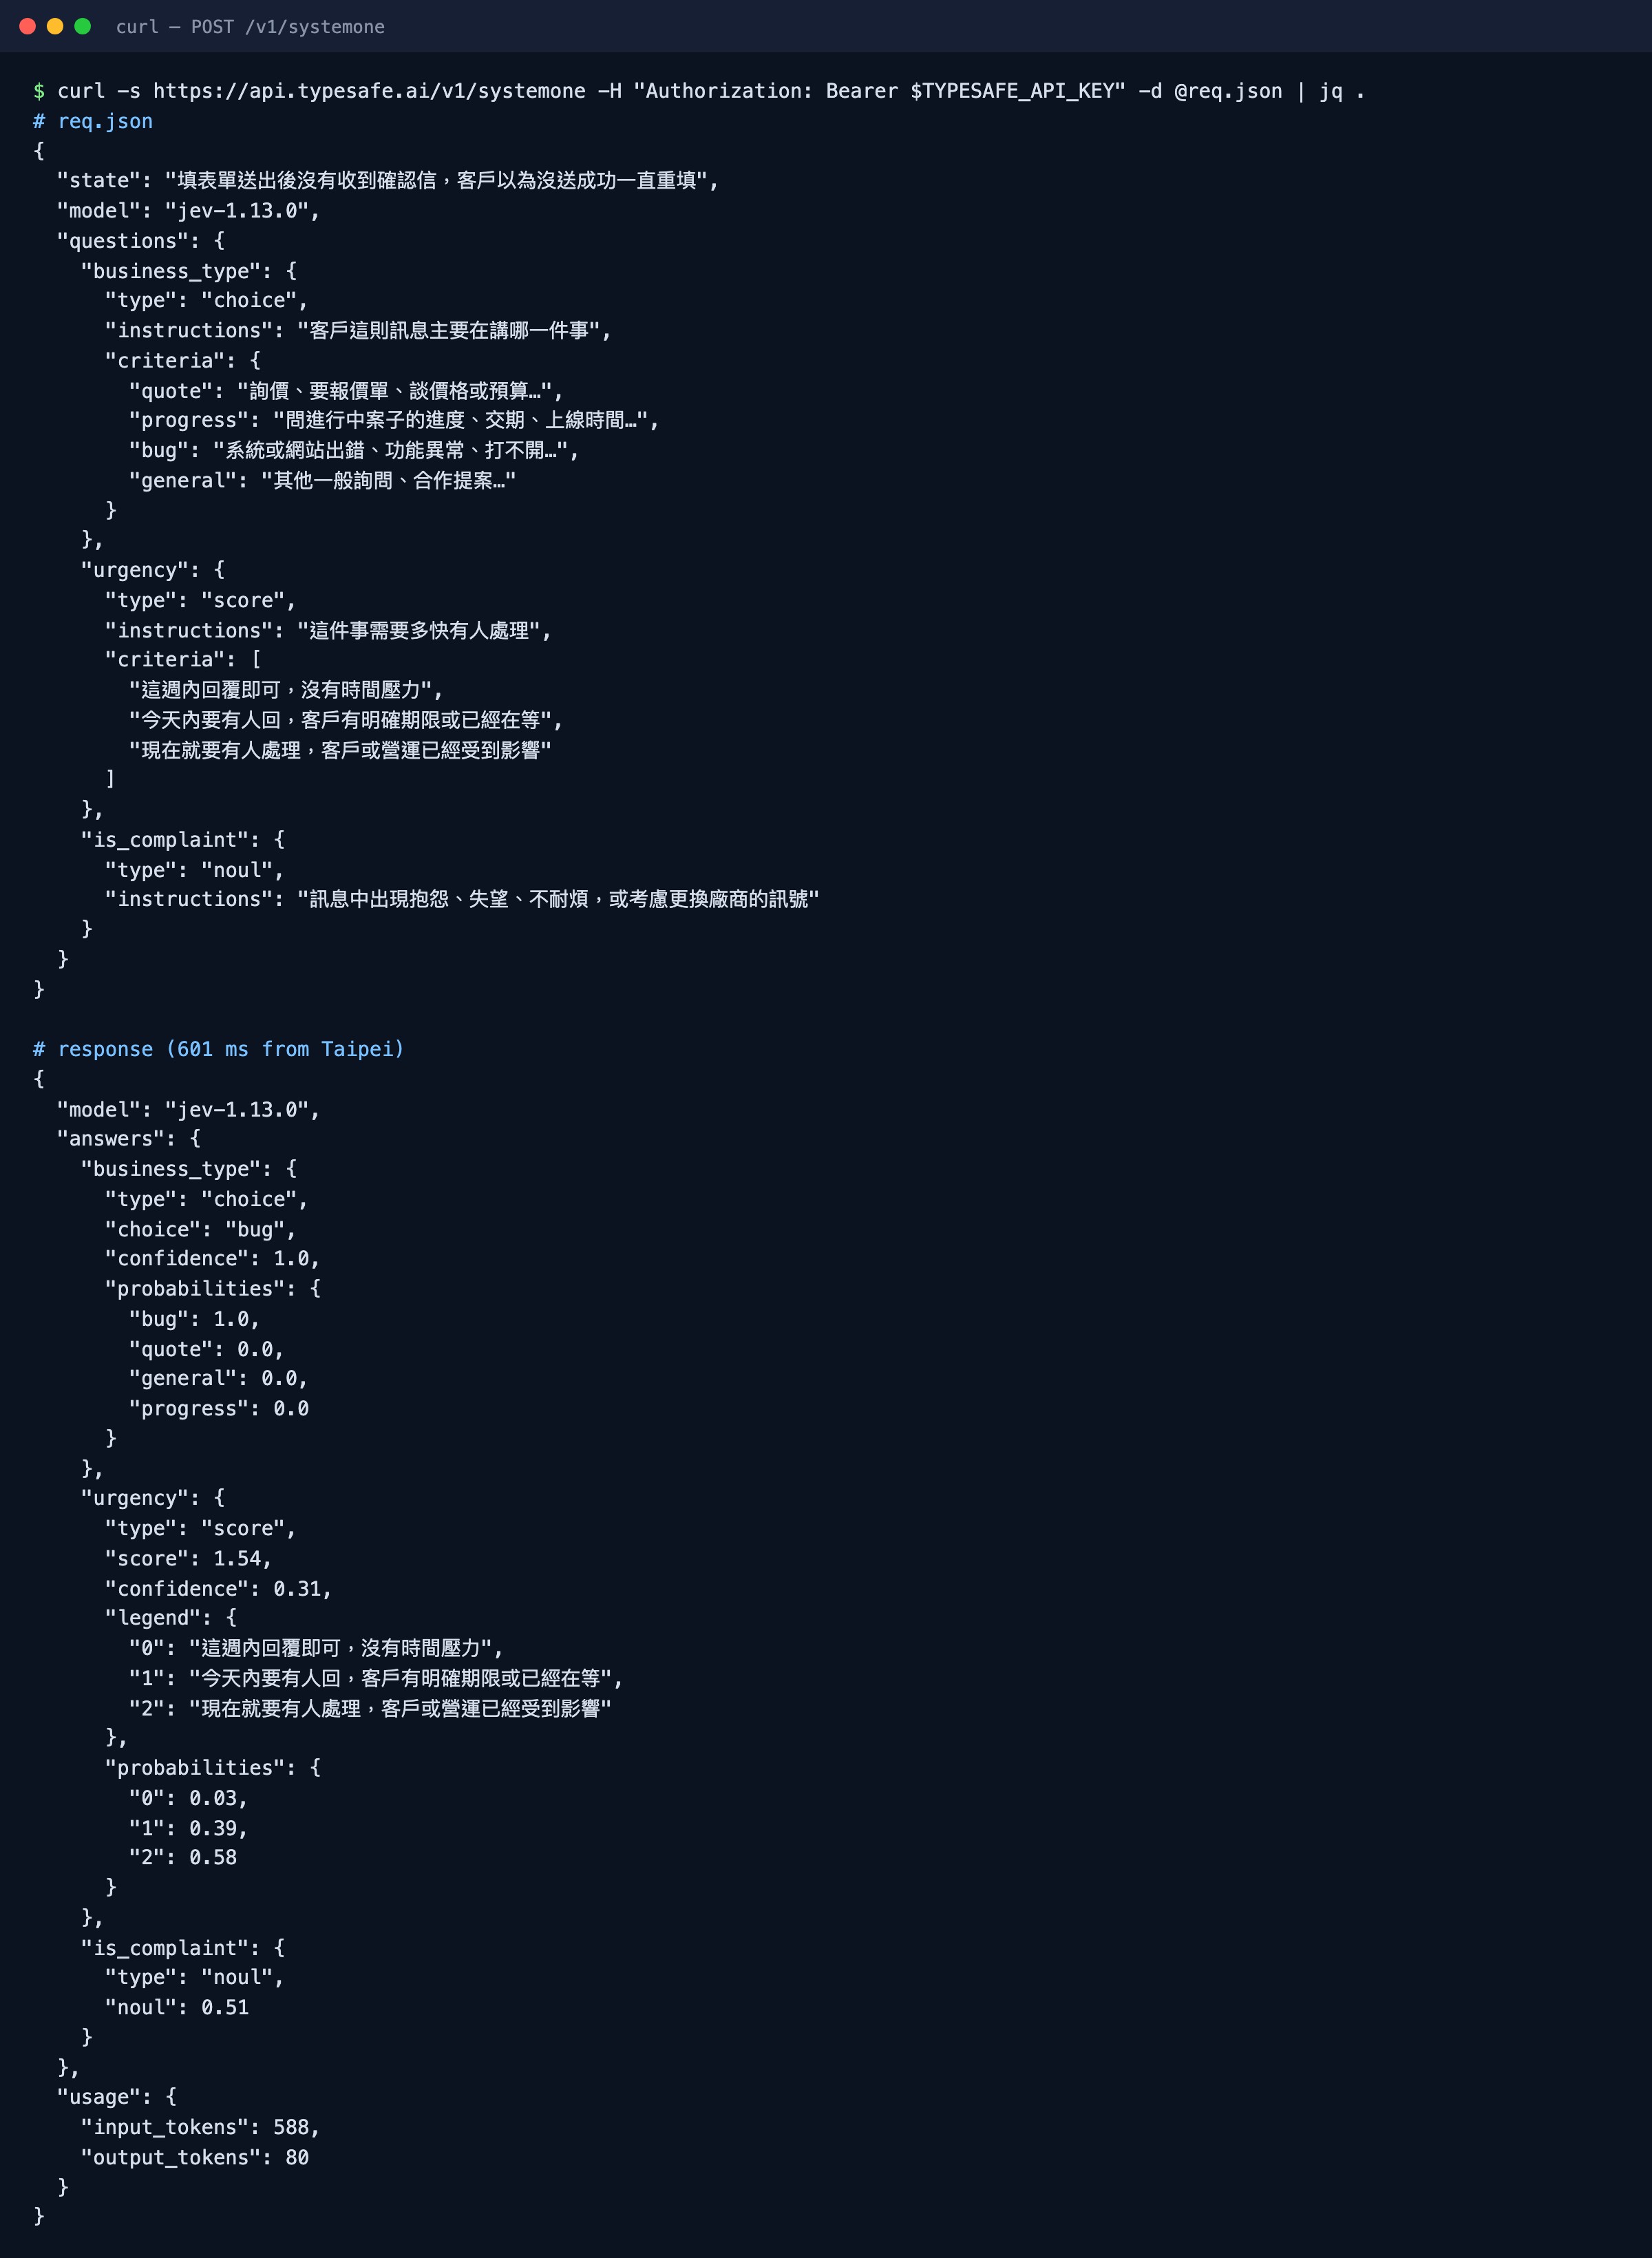
這筆很有代表性:business_type 信心 1.0 判 bug,沒有懸念;urgency 的 score 是 1.54 但 confidence 只有 0.31,機率分在「今天內」0.39 與「現在」0.58 之間,模型在說「很急,但多急我不確定」;is_complaint 0.51 剛好卡在中間,客戶還沒抱怨但快了。程式該做的事是:自動指派給技術團隊、緊急度取 score 過 1.5 當「現在」處理、抱怨旗標不亮但記錄下來。三個答案各自有各自的門檻,這就是官方講的「門檻隨風險走」。
問題 | 我們會設的門檻 | 為什麼 |
|---|---|---|
business_type(Choice) | confidence ≥ 0.7 自動指派;0.5 到 0.7 帶著機率丟給 LLM 二審;< 0.5 直接人工 | 0.7 在這份資料上是 92% 覆蓋、97.1% 正確;0.5 以下 11 筆錯 6 筆,沒有二審價值 |
urgency(Score) | score ≥ 1.5 當「現在」、≥ 0.5 當「今天內」;confidence < 0.3 的另外標記 | 模型偏向往上判一級,對客服安全;Score 的 confidence 低代表卡在兩級間,人看一眼就好 |
is_complaint(Noul) | ≥ 0.7 亮旗標給主管,不觸發任何自動動作 | recall 100% 但誤抓 7.7%,當提醒剛好,當動作會誤傷砍價與催進度的客戶 |
mentions_contract(Noul,本次未測) | ≥ 0.5 整封進人工 | 合約與法務是紅線,寧可多進人工 |
state 前處理 | 砍簽名檔、引用、免責聲明;只留正文 + 客戶等級 + 上一張工單摘要 | 雜訊實驗證明精準 criteria 配髒 state 會掉 5 個百分點 |
模型版本 | 固定 jev-1.13.0,換版時整份資料重跑一次再決定門檻 | 門檻是對著這個版本的分佈畫的,別名一換分佈就會動 |
上線方式照技術解析那篇講的影子模式:先只記錄不執行,兩到四週後拿 log 對主管實際指派結果重畫曲線,再放行自動路徑。之後每週看一次 confidence 分佈有沒有移動,移動就是資料變了或模型換版了,處理方式照AI 客服 drift 治理那套。進件如果來自 LINE 官方帳號,前面的接法照LINE 官方帳號接 AI 的三種路徑,Jev 只是換掉中間那個判斷節點;人工 queue 那一端怎麼排班,AI 客服與真人混合排班 SOP有現成的班表。
跟著這篇把 221 筆跑一次不難,難的是把它變成公司每天在用的東西。從「跑出 94%」到「客服主管每天真的少花一小時」之間,差的是一層客製:你的分類定義怎麼寫成 criteria、你的 email 與 LINE 訊息怎麼清成乾淨的 state、門檻怎麼從你的資料畫出來、人工 queue 怎麼接回你在用的 CRM。少了這一層,它就是一個很快的 API;有了這一層,它才是流程裡的一個節點。
不用一次到位,從你最頭痛的那一條流程開始就好,通常是客服分流或詢價初判。先聊一下你現在的情況,我們會直接告訴你「這個值得做嗎、大概怎麼做」,這個階段我們陪你一起想,後面真的要動手再談範圍跟費用。可以把你公司現在的流程丟過來,我們很樂意聽你聊聊現況,一起看看哪幾個判斷點適合先拆出來。
我們怎麼看:繁體中文可以用,但要用對地方
ℹ️我們怎麼看
跑完這 221 筆,我們對「Jev 能不能用在台灣客服」的答案是可以,而且比預期好。四類分類 94% 起跳、寫好 criteria 到 96%,高信心那段接近 99%,這已經超過我們 LLM 版分流在同類任務上的穩定度,成本又低到可以忽略。但它的用法跟 LLM 完全不同:它不會替你補情境,你寫什麼它答什麼,所以 criteria 是產品的一部分、state 的清潔度是產品的一部分。我們的判斷是,三年後這一層「便宜、可設門檻的判斷器」會變成客服與業務系統的標配,模型叫什麼名字反而不重要;先把公司裡的判斷點列出來、先養出一份自己的標註資料,才是現在最值得做的事。對中小企業老闆來說,這篇最該帶走的一句是:拿 200 筆自己的訊息、花不到一塊錢跑一次,你就知道該不該往下走。
LangChain 的整合文章把 Jev 定位成 agent 控制層的判斷器,TypeSafe 自己也強調它是 LLM 的補充而非替代。我們的實測跟這個定位一致:它在「答案範圍固定、情境已經整理好」的題目上很強,在需要推情境的題目上會照字面走。知道這條界線在哪,比知道它有多快重要。想從頭理解企業導入 AI 該怎麼排優先序,企業 AI 導入指南那篇有整套框架。
我們公司內部最省時間的三個 AI 流程,八成中小企業都用得上,而且它們的核心全部是選擇題。你公司現在最頭痛的是哪一塊?可以把現況丟過來,我們陪你一起看看適合的解法。
ℹ️我們做過這件事
順帶說一下,這篇的分流架構我們公司自己每天都在跑,目前內部有 20+ 個 AI 流程在工作中,客服分流就是其中一條,這次的 221 筆實測就是對著那條流程的三層設計出來的。我們自己每天在用的 SalesKing,AI 讀完 LINE 對話判斷客戶處在哪個銷售階段,那一層判斷跟本文的 business_type 是同一種題目。看到這裡,如果你也在想「這套放在我們公司會是什麼樣子」,我們很樂意聽你聊聊現在的實際情況,一起看看哪些做得起來、能從哪一塊開始。
AI 導入評估表下載
還沒決定該從哪個流程開始的話,這份評估表把「判斷點盤點、資料就緒度、風險等級」三件事做成可以自己填的表格,填完你會知道公司裡哪幾題選擇題最值得先讓 AI 接手。下載 AI 導入評估表(PDF)
QJev 支援繁體中文嗎?實測準確率多少?
支援。我們用 221 筆台灣客服訊息實測 jev-1.13.0,四類分類正確率 94.1%,把台灣講法寫進 criteria 後 96.4%;confidence 0.9 以上的答案正確率 98.4%。混入的 9 筆英文與簡體全部答對。
Q這份資料集是真實客戶資料嗎?
是仿真資料。我們不把客戶內容送進第三方 API。221 筆由我們依真實進件句型、LINE 口語、PTT 與 Dcard 常見問法撰寫並人工標註,刻意混入錯字、簡體、英文、超短訊息與垃圾廣告。資料集與腳本都開在 GitHub。
Qconfidence 門檻該設多少?
在這份資料上 0.7 是 92% 自動處理、97.1% 正確的位置,但門檻要對著你自己的資料重畫,因為它綁著模型版本與資料分佈。做法是先跑影子模式記錄兩到四週,拿 log 對人工結果畫覆蓋率與正確率曲線,再從曲線讀門檻。
QJev 在中文上最常錯什麼?
錯的多半是字面解讀:「這問題反映一個月都沒人處理」被判成進度而非系統問題,因為句子裡沒有「壞掉」「錯誤」這類詞。解法是把台灣人的講法與邊界寫進 criteria,這次實驗把正確率拉高 2.3 個百分點。
Qstate 裡有簽名檔或引用會怎樣?
原始 criteria 幾乎不受影響,但寫得精準的 criteria 會被雜訊裡的內容帶偏:我們塞 300 token 的 email 簽名檔與會議紀錄引用後,改良版 criteria 從 96.4% 掉到 91.4%。程式先砍掉簽名檔與引用是必要的前處理。
Q跑這 221 筆花了多少錢、多久?
127,987 個輸入 token、0.0054 美元;四輪實驗共 0.027 美元。從台北呼叫的延遲中位數 611 毫秒,4 個並發 44 秒跑完。
讀到這裡,你手上應該有一份可以直接照抄的門檻表跟一個可以重跑的腳本。想知道換成你的訊息會跑出什麼數字、或 n8n 與 CRM 那一段該怎麼接,跟我們聊聊你的 AI 導入需求,我們會先幫你看哪一題最值得先動、大概怎麼做最划算,再談要不要真的動手。
AUTHOR
恆遠數位編輯團隊
想了解更多?看看我們的相關服務
相關文章
Jev 模型是什麼?TypeSafe System One 決策模型技術解析:三種問題型態、信心分數門檻、9 個已知弱點,以及怎麼接進客服分流與既有系統
生成式 AI 企業導入 2026:跟一般 AI 專案差在哪、6 個落地場景與資料外流的 4 條防線

中小企業 AI vendor stack 整併決策 SOP:從 15 家 point solution 到 3-4 anchor 供應商,6 個整併訊號、5 條合約紅線、4 個垂直整合陷阱

我們公司怎麼跑出 20+ AI 流程?系列第 4 篇:每日部落格 SEO 寫稿自動化 SOP,4 階段 pipeline、5 條品質紅線、3 個跳過寫稿的判斷條件

我們公司怎麼跑出 20+ AI 流程?系列第 3 篇:客戶服務分流自動化 SOP,3 層分流、4 個信心分數、2 條人類接手紅線

留言(0)
尚無留言,成為第一個留言的人吧!