Laya 繁體中文實測:221 筆台灣客服訊息零樣本只有 44.8%,用 150 筆手標資料在 Mac mini 上微調 609 秒後拉到 77.5%
Laya 模型對繁體中文客服訊息的零樣本分類正確率是 44.8%,同一批訊息 Jev 是 94.1%。我們拿 221 筆台灣客服訊息、四個類別(詢價、進度、系統問題、一般詢問)實測 laya-multilingual,跑在一台 M1 Mac mini 的 CPU 上,單題中位數 86 毫秒。用 150 筆手標資料微調 609 秒之後,在保留的 71 題上從 46.5% 拉到 77.5%,但信心門檻整個失效了。
這篇是Laya 模型介紹的續集,也是Jev 繁體中文實測的對照組。做法很簡單:同一份資料集、同一組問題定義、逐字相同的選項描述,只把模型換掉。腳本、原始回應、切分檔全部開在 GitHub 上讓你自己重跑。
寫這篇的動機是中文圈的討論已經歪了。Laya 開源後,「開源模型秒殺閉源 API」的說法在各大論壇傳得很快,但幾乎所有文章引用的都是官方那張比較表,沒有人拿中文資料實際跑過。官方自己在說明文件裡寫得很清楚:基礎 checkpoint 的零樣本成績只有 0.362,那個亮眼的 0.766 屬於微調後的版本。我們想知道的是,這句警告換成台灣客戶會講的話,實際長什麼樣。
先把整份實驗的結論放在一張表,後面每節展開。
問題 | 實測答案 |
|---|---|
繁中零樣本分類正確率 | 44.8%(亂猜 25%、永遠猜最大類 27.6%) |
最嚴重的症狀 | 類別塌陷:221 筆有 140 筆判成同一類,60 筆一般詢問只判對 1 筆 |
改寫更詳細的選項描述有救嗎 | 反而更糟,掉到 26.7%,塌陷惡化成 204 筆 |
微調要多久多少錢 | 150 筆手標資料、M1 Mac mini 的 CPU、609 秒、0 元 |
微調後(同 71 題) | 分類 77.5%、緊急度 81.7%,Jev 同題是 90.1% 與 90.1% |
微調修好了什麼 | 類別塌陷消失,預測分佈幾乎貼合實際分佈 |
微調弄壞了什麼 | 信心校準。門檻拉到 0.9 仍覆蓋 93%,正確率文風不動 |
延遲 | M1 CPU 單題 86 毫秒;Jev 從台北呼叫 611 毫秒 |
適合現在上線嗎 | 資料不能出境或要壓低延遲才值得;否則付費 API 現階段省事太多 |
實驗怎麼設計:同一份資料、逐字相同的問題
公平的對照只有一種做法,就是只換一個變數。我們沿用Jev 那輪的 221 筆資料集與三個問題,連選項描述都一字未改。
項目 | 設定 |
|---|---|
資料 | 221 筆仿真台灣客服訊息,人工標好三個答案 |
類別分佈 | 詢價 61、進度 50、系統問題 50、一般詢問 60 |
問題一 | business_type,choice,四選一 |
問題二 | urgency,score,三級(這週內/今天內/現在) |
問題三 | is_complaint,noul,有沒有抱怨或想換廠商 |
模型 | convaiinnovations/laya 的 multilingual 子資料夾 |
硬體 | Mac mini M1、16GB 記憶體、純 CPU 推論 |
對照組 | Jev 1.13.0,同一批題目,已在前一篇跑完 |
資料集是我們自己寫的仿真訊息,句型取自官網真實進件的寫法、LINE 上客戶會打的口語、以及論壇常見問法,並刻意混進錯字、簡體、英文、只有兩個字的超短訊息、垃圾廣告,還有「客氣但其實在生氣」這種台灣特有的邊角案例。我們不把客戶寫的內容送進第三方服務,這個原則在自架模型這一輪其實不成立(它跑在自己機器上),但為了跟 Jev 那輪可比,我們用同一份資料。
順帶講一下我們為什麼在意這題。SalesKing是我們自己每天在用的 CRM,AI 讀完 LINE 對話後判斷客戶處在哪個銷售階段、生成追蹤計畫,那一層判斷跟這裡的四選一是同一種形狀。如果開源模型能把這層做到堪用,整條流程的成本結構與資料流向都會不一樣。如果你手上的系統也有這種「先判斷、再動作」的節點,可以直接跟我們聊,我們會先幫你看哪幾題適合怎麼拆。
零樣本 44.8%:它把六成訊息判成同一類
先給答案:221 筆錯了 122 筆,而且錯得很有規律。下面是跑完報表的原始終端機畫面。
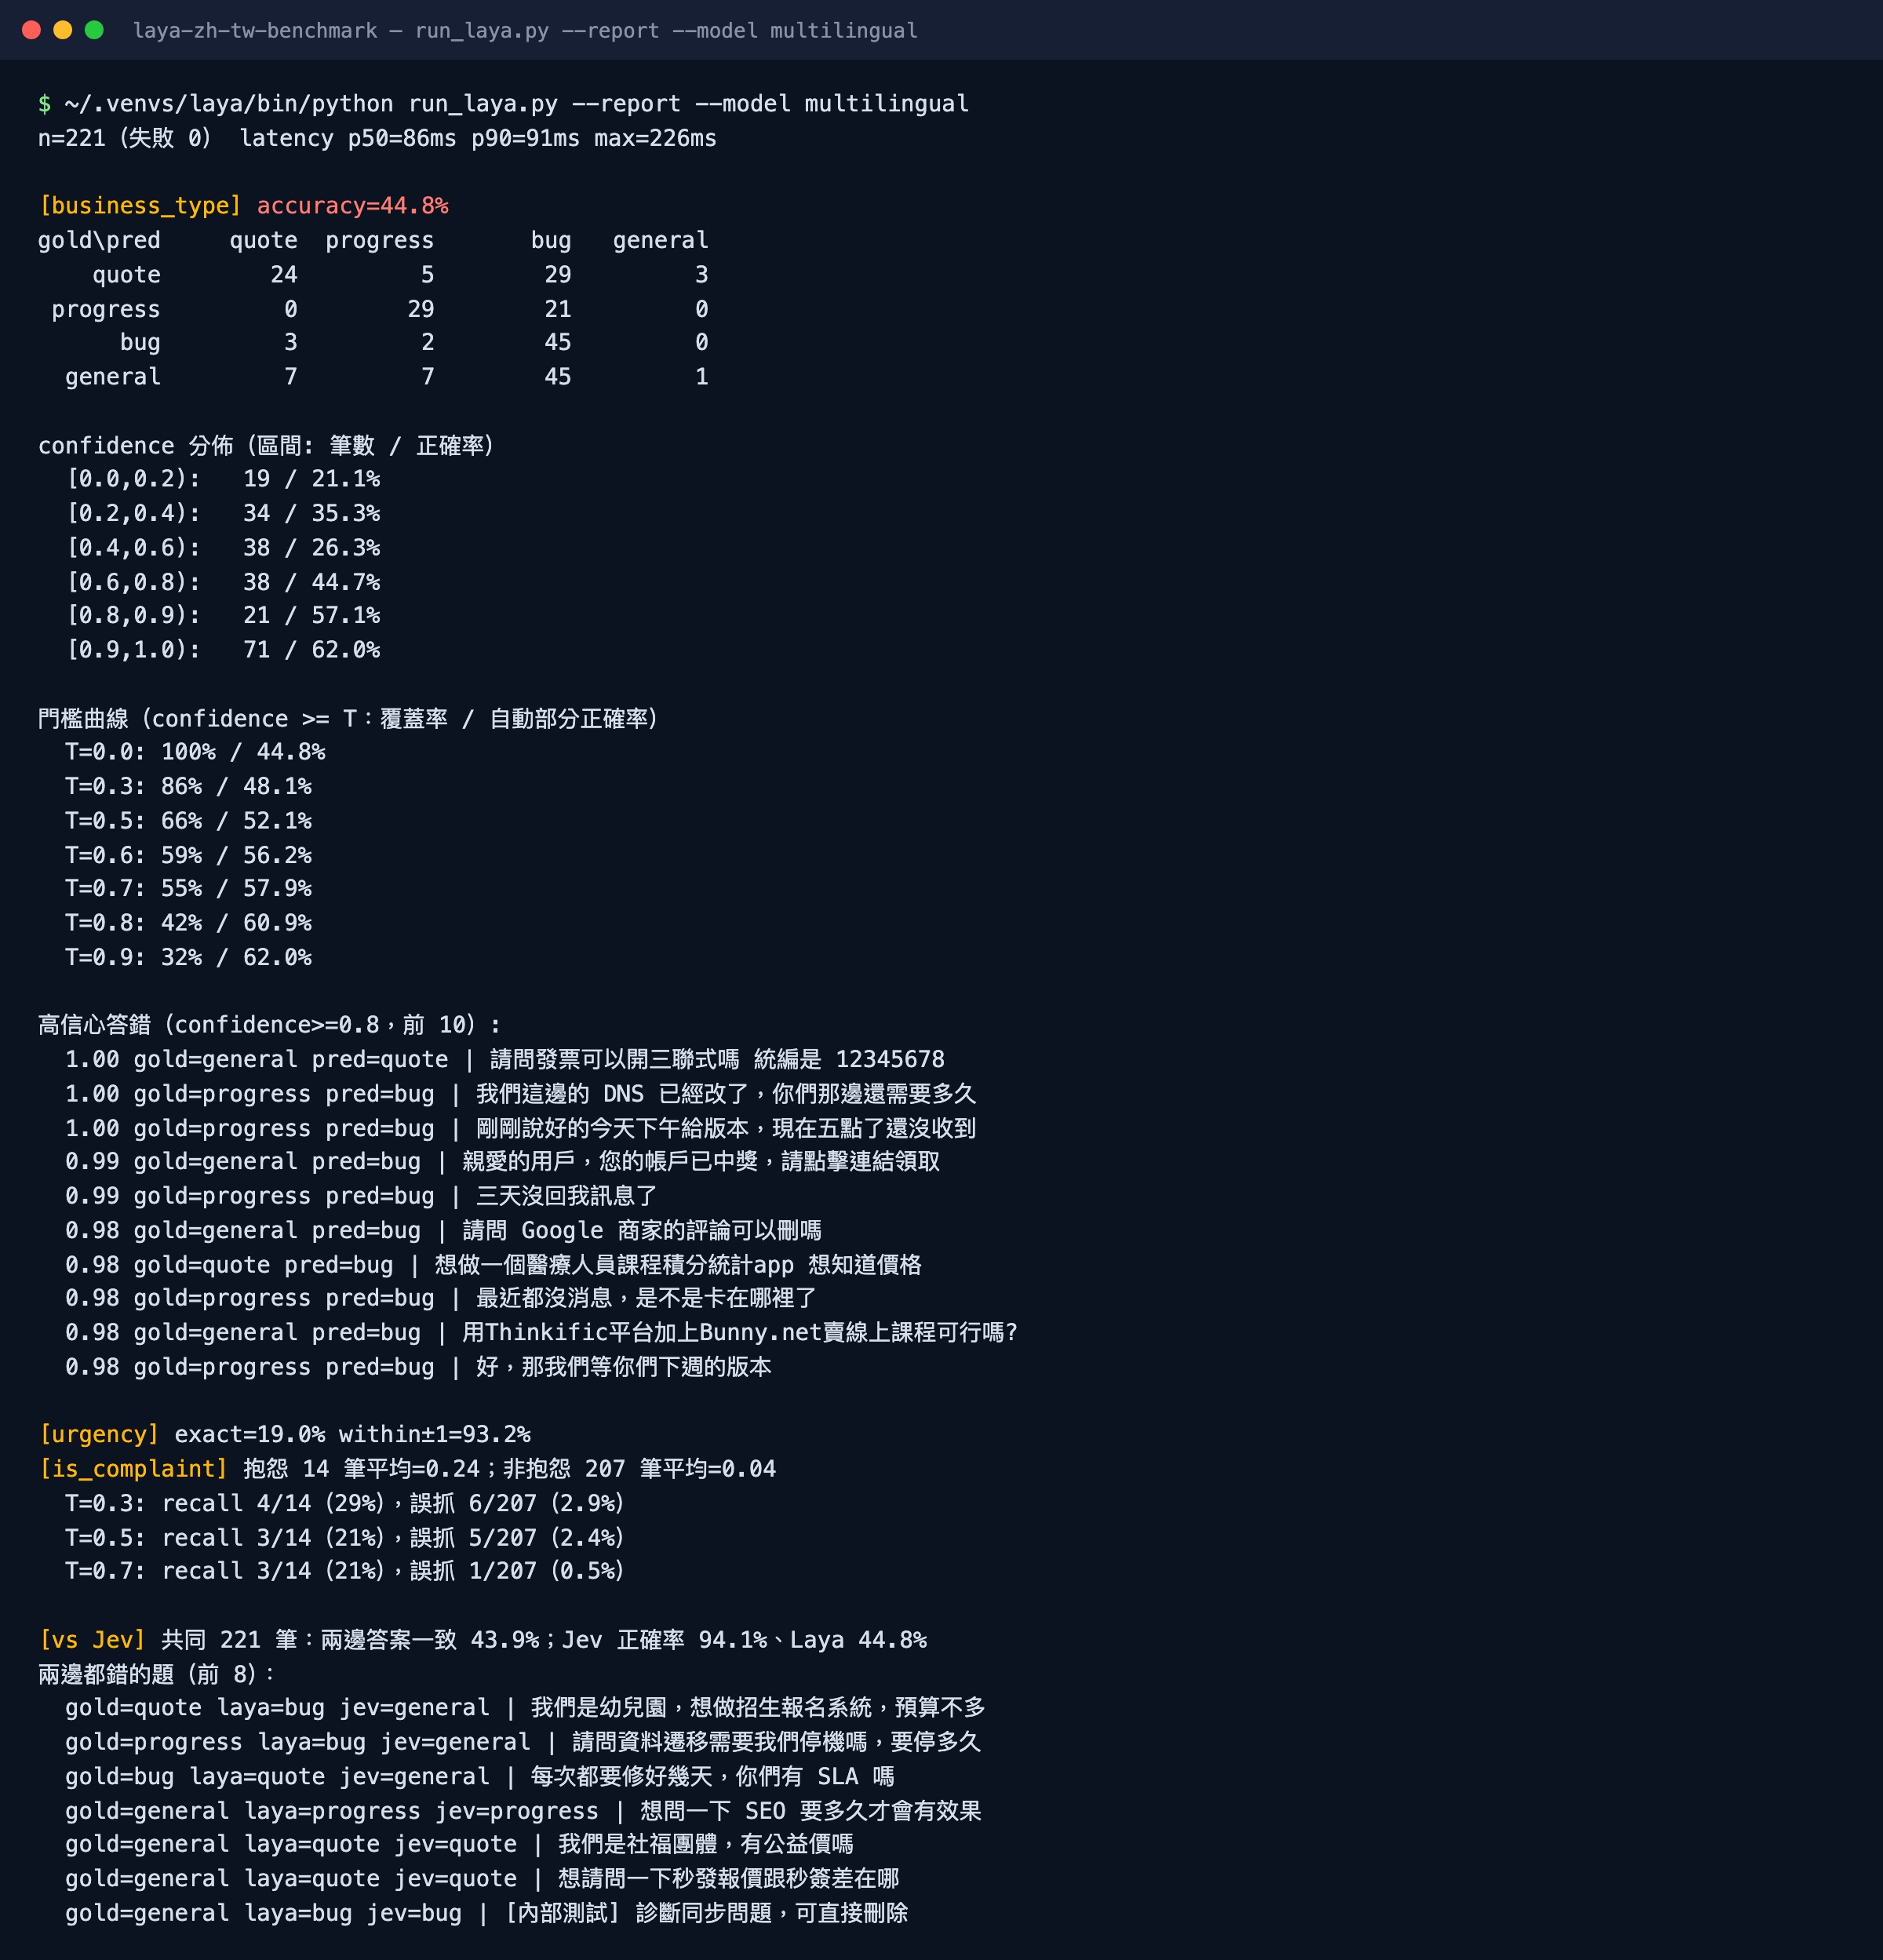
實際類別 \ 模型判成 | 詢價 | 進度 | 系統問題 | 一般詢問 |
|---|---|---|---|---|
詢價(61) | 24 | 5 | 29 | 3 |
進度(50) | 0 | 29 | 21 | 0 |
系統問題(50) | 3 | 2 | 45 | 0 |
一般詢問(60) | 7 | 7 | 45 | 1 |
看這張表要看的是「系統問題」那一欄:221 筆裡有 140 筆掉進去,等於六成三的訊息都被判成系統故障。反過來,60 筆一般詢問只有 1 筆判對,召回率 2%。這種現象叫類別塌陷,模型幾乎放棄區分,整個往一個類別倒。
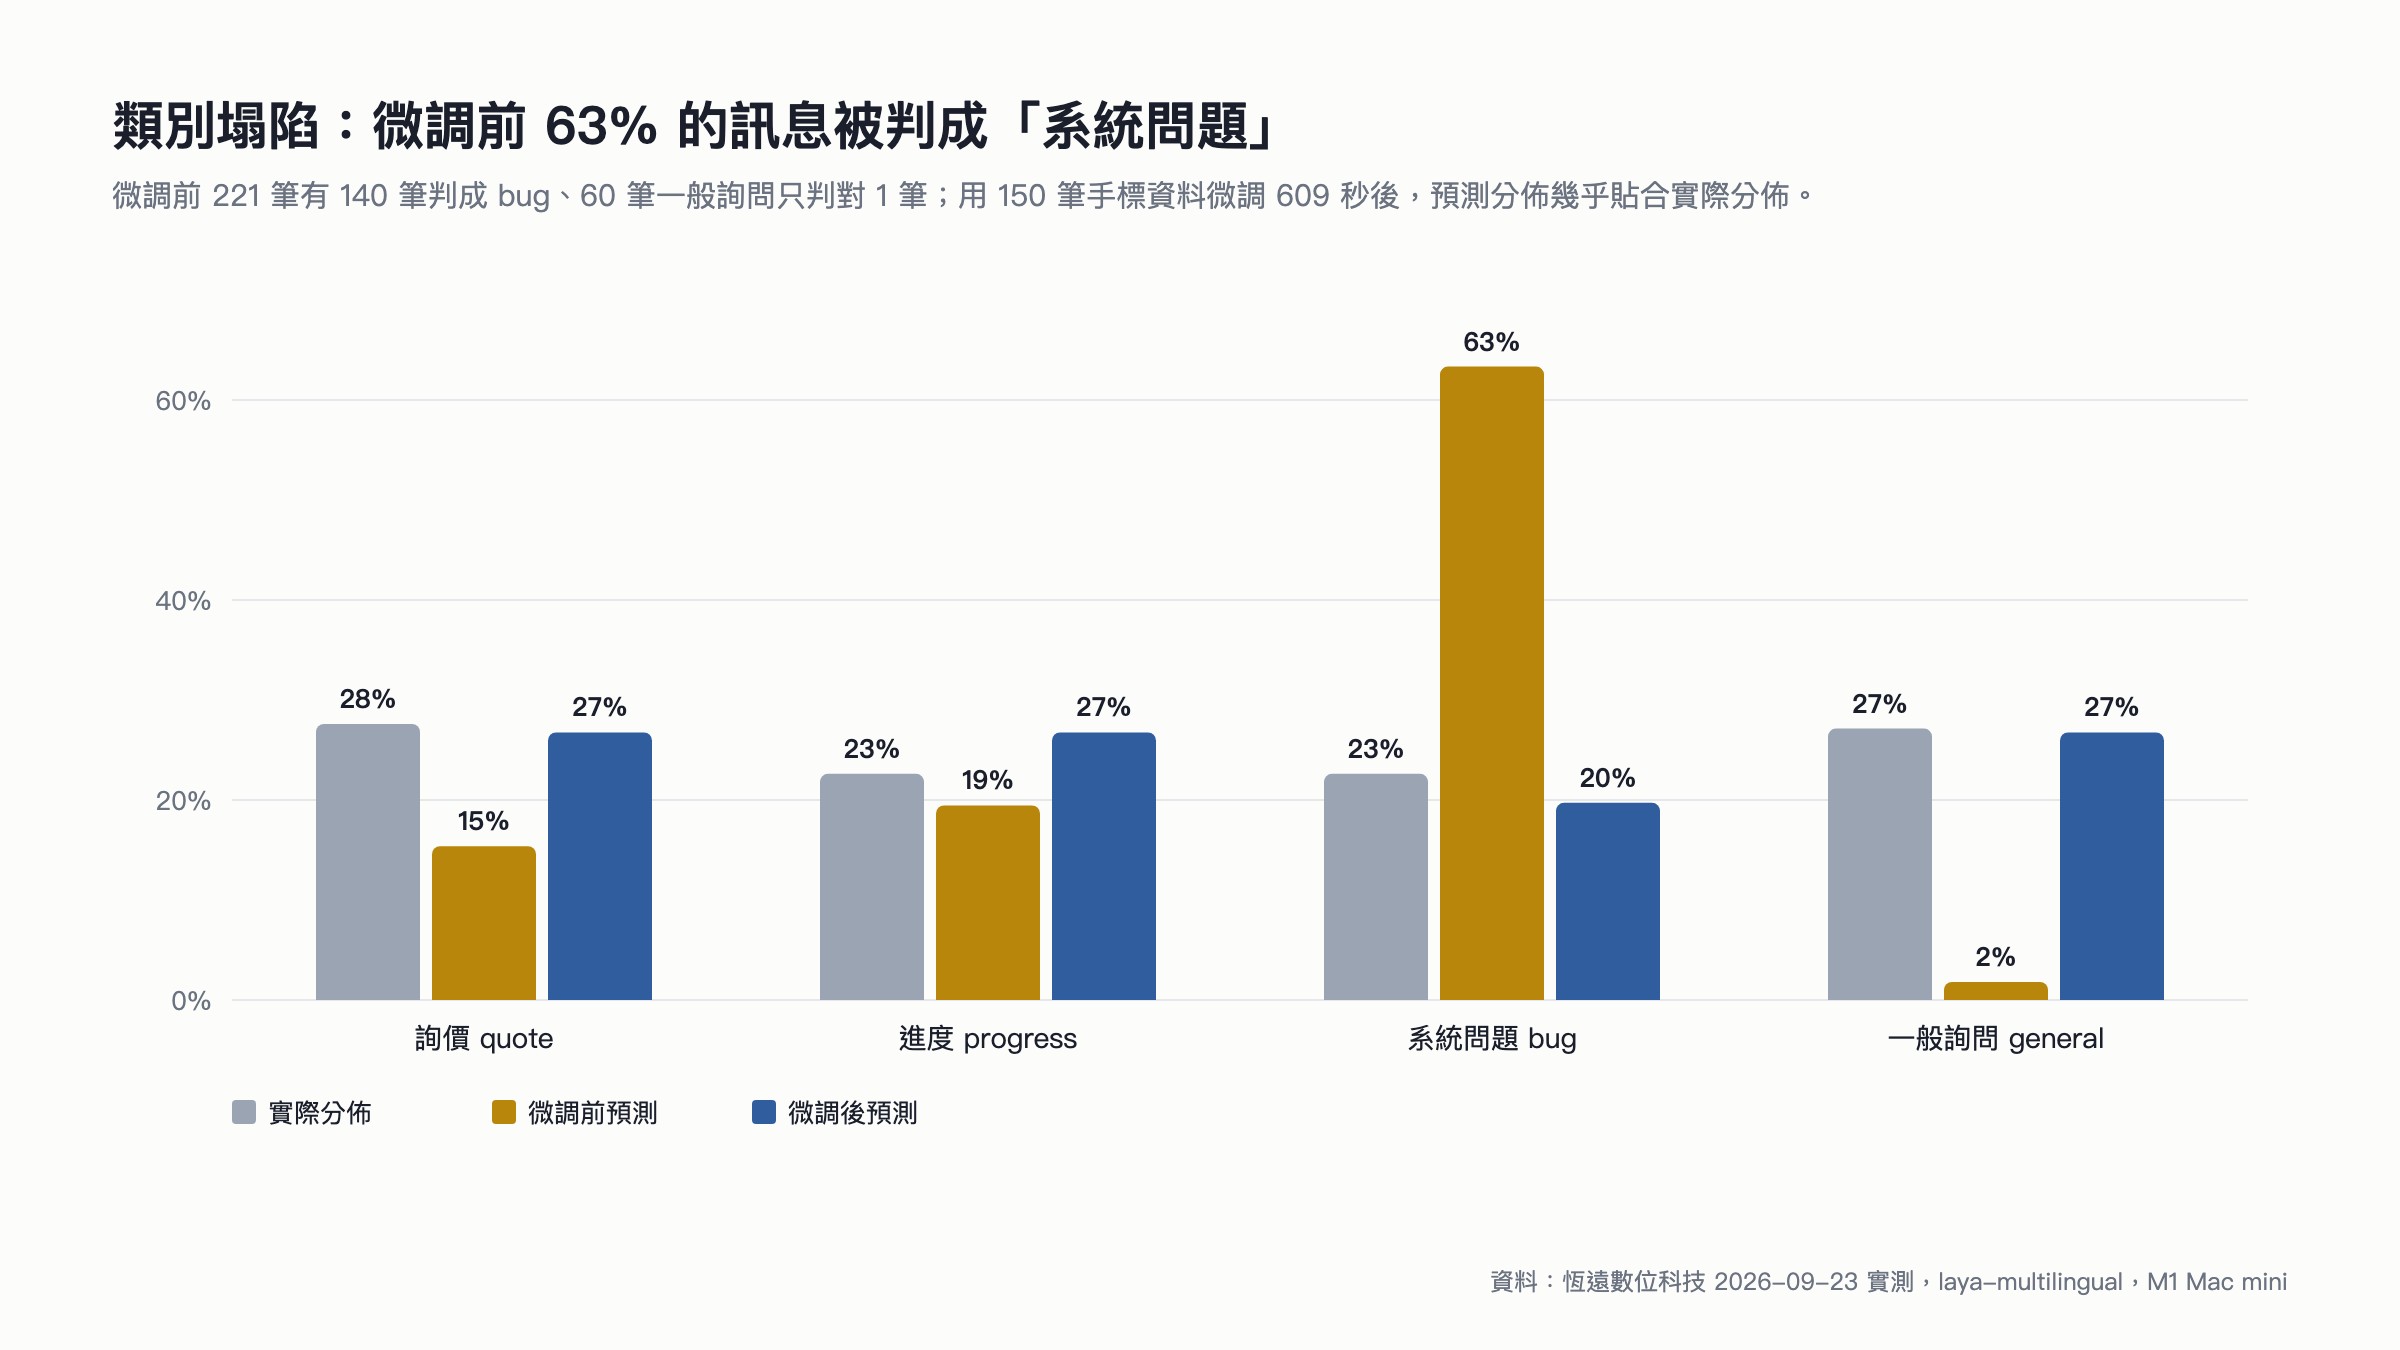
類別 | 實際筆數 | 被判成這類 | 召回率 | 精確率 |
|---|---|---|---|---|
系統問題 | 50 | 140 | 90% | 32% |
一般詢問 | 60 | 4 | 2% | 25% |
詢價 | 61 | 34 | 39% | 71% |
進度 | 50 | 43 | 58% | 67% |
而且它塌得很有自信
最麻煩的地方在信心分數擋不住。高信心答錯的前幾名長這樣:
- 「請問發票可以開三聯式嗎 統編是 12345678」判成詢價,信心 1.00
- 「我們這邊的 DNS 已經改了,你們那邊還需要多久」判成系統問題,信心 1.00
- 「親愛的用戶,您的帳戶已中獎,請點擊連結領取」這封垃圾信判成系統問題,信心 0.99
- 「好,那我們等你們下週的版本」判成系統問題,信心 0.98
信心門檻 | 覆蓋率 | 自動處理部分的正確率 | 同門檻的 Jev |
|---|---|---|---|
0.5 | 66% | 52.1% | 97% / 95.8% |
0.7 | 55% | 57.9% | 92% / 97.1% |
0.9 | 32% | 62.0% | 86% / 98.4% |
門檻拉到 0.9 只剩三成訊息,那一段的正確率也才 62%。這代表整套「信心低就交給人」的安全機制在零樣本的 Laya 上是失效的,因為它對錯的答案一樣有把握。
其他兩個問題也一起垮。緊急度三級評分完全命中只有 19.0%(差一級以內 93.2%);抱怨偵測更慘,14 筆真抱怨的機率值有一半以上低於 0.05,門檻 0.3 時只抓到 4 筆。對照 Jev 在同一份資料上是緊急度 84.2%、抱怨召回 100%。
錯誤裡也有訊號
把 122 筆錯誤逐筆掃過之後,有一個現象值得記下來:詢價這一類的精確率是四類裡最高的 71%,代表只要它說「這是詢價」,通常真的是詢價,只是它常常不敢說。進度那類也有 67%。壞掉的是系統問題那一類,它變成一個什麼都收的垃圾桶。
這個分佈給了一條實務上的暫用辦法:如果你今天非得用零樣本的 Laya 不可,可以只信任「詢價」與「進度」這兩個答案,其餘全部進人工。這樣等於把四類分類降級成兩個高精確率的旗標,雖然覆蓋率很低,但至少不會把客訴丟去業務部。
把選項描述寫得更清楚,結果更糟
先給答案:同一招在 Jev 上加 2.3 個百分點,在 Laya 上減 18.1 個百分點。
在 Jev 那輪,我們把台灣人的講法與類別邊界寫進選項描述(例如詢價補上「有沒有優惠或公益價」「只要是在談錢或要報價就算這類」),正確率從 94.1% 升到 96.4%。這次把逐字相同的那一版換上去重跑,結果是這樣:
設定 | 分類正確率 | 被判成系統問題的筆數 |
|---|---|---|
原始選項描述(每項一句) | 44.8% | 140 / 221 |
詳細版選項描述(每項兩三句) | 26.7% | 204 / 221 |
原因出在架構。Laya 的所有選項共用一個固定的 token 預算(多語言版是 256),描述寫得越長,每個選項分到的空間越被擠壓,四個選項之間反而變得難以區分。這跟官方揭露的 Banking77 弱項是完全同一個機制:77 個選項時每個只分到三到四個 token,準確率掉到 0.425。我們只用四個選項、把描述寫長,就提早觸發了同樣的現象。
⚠️在 Jev 上調好的問題定義不能直接搬到 Laya
兩個模型的最佳寫法方向相反。Jev 讀得懂補充說明,選項描述寫越細越準;Laya 的選項共用固定預算,描述要短、要互斥、要用最少的字把邊界講清楚。想從付費 API 換成開源自架的團隊,這一層要整個重寫,不是複製貼上。
微調:150 筆手標資料,在 Mac mini 上跑 609 秒
先給答案:微調把分類從 46.5% 拉到 77.5%、緊急度從 22.5% 拉到 81.7%,成本是零元加十分鐘。
既然改問題定義沒救,剩下的路只有微調。官方把微調 notebook一起開源了,原版是寫給雙 T4 顯示卡跑分散式訓練。我們把它改成單機版,改動只有把分散式那層拆掉、顯示卡換成 CPU、關掉半精度自動轉換。損失函數與全部超參數一字未動,這樣數字才對得起官方方法。
設定 | 值 |
|---|---|
訓練資料 | 150 筆(四類比例與母體一致,種子固定) |
測試資料 | 71 筆,完全沒參與訓練 |
訓練序列 | 450 條(150 筆 × 3 題) |
epoch | 4 |
硬體 | M1 Mac mini,純 CPU |
訓練耗時 | 609 秒 |
平均損失 | 0.56 → 0.61 → 0.36 → 0.26 |
花費 | 0 元,不需要任何雲端帳號 |
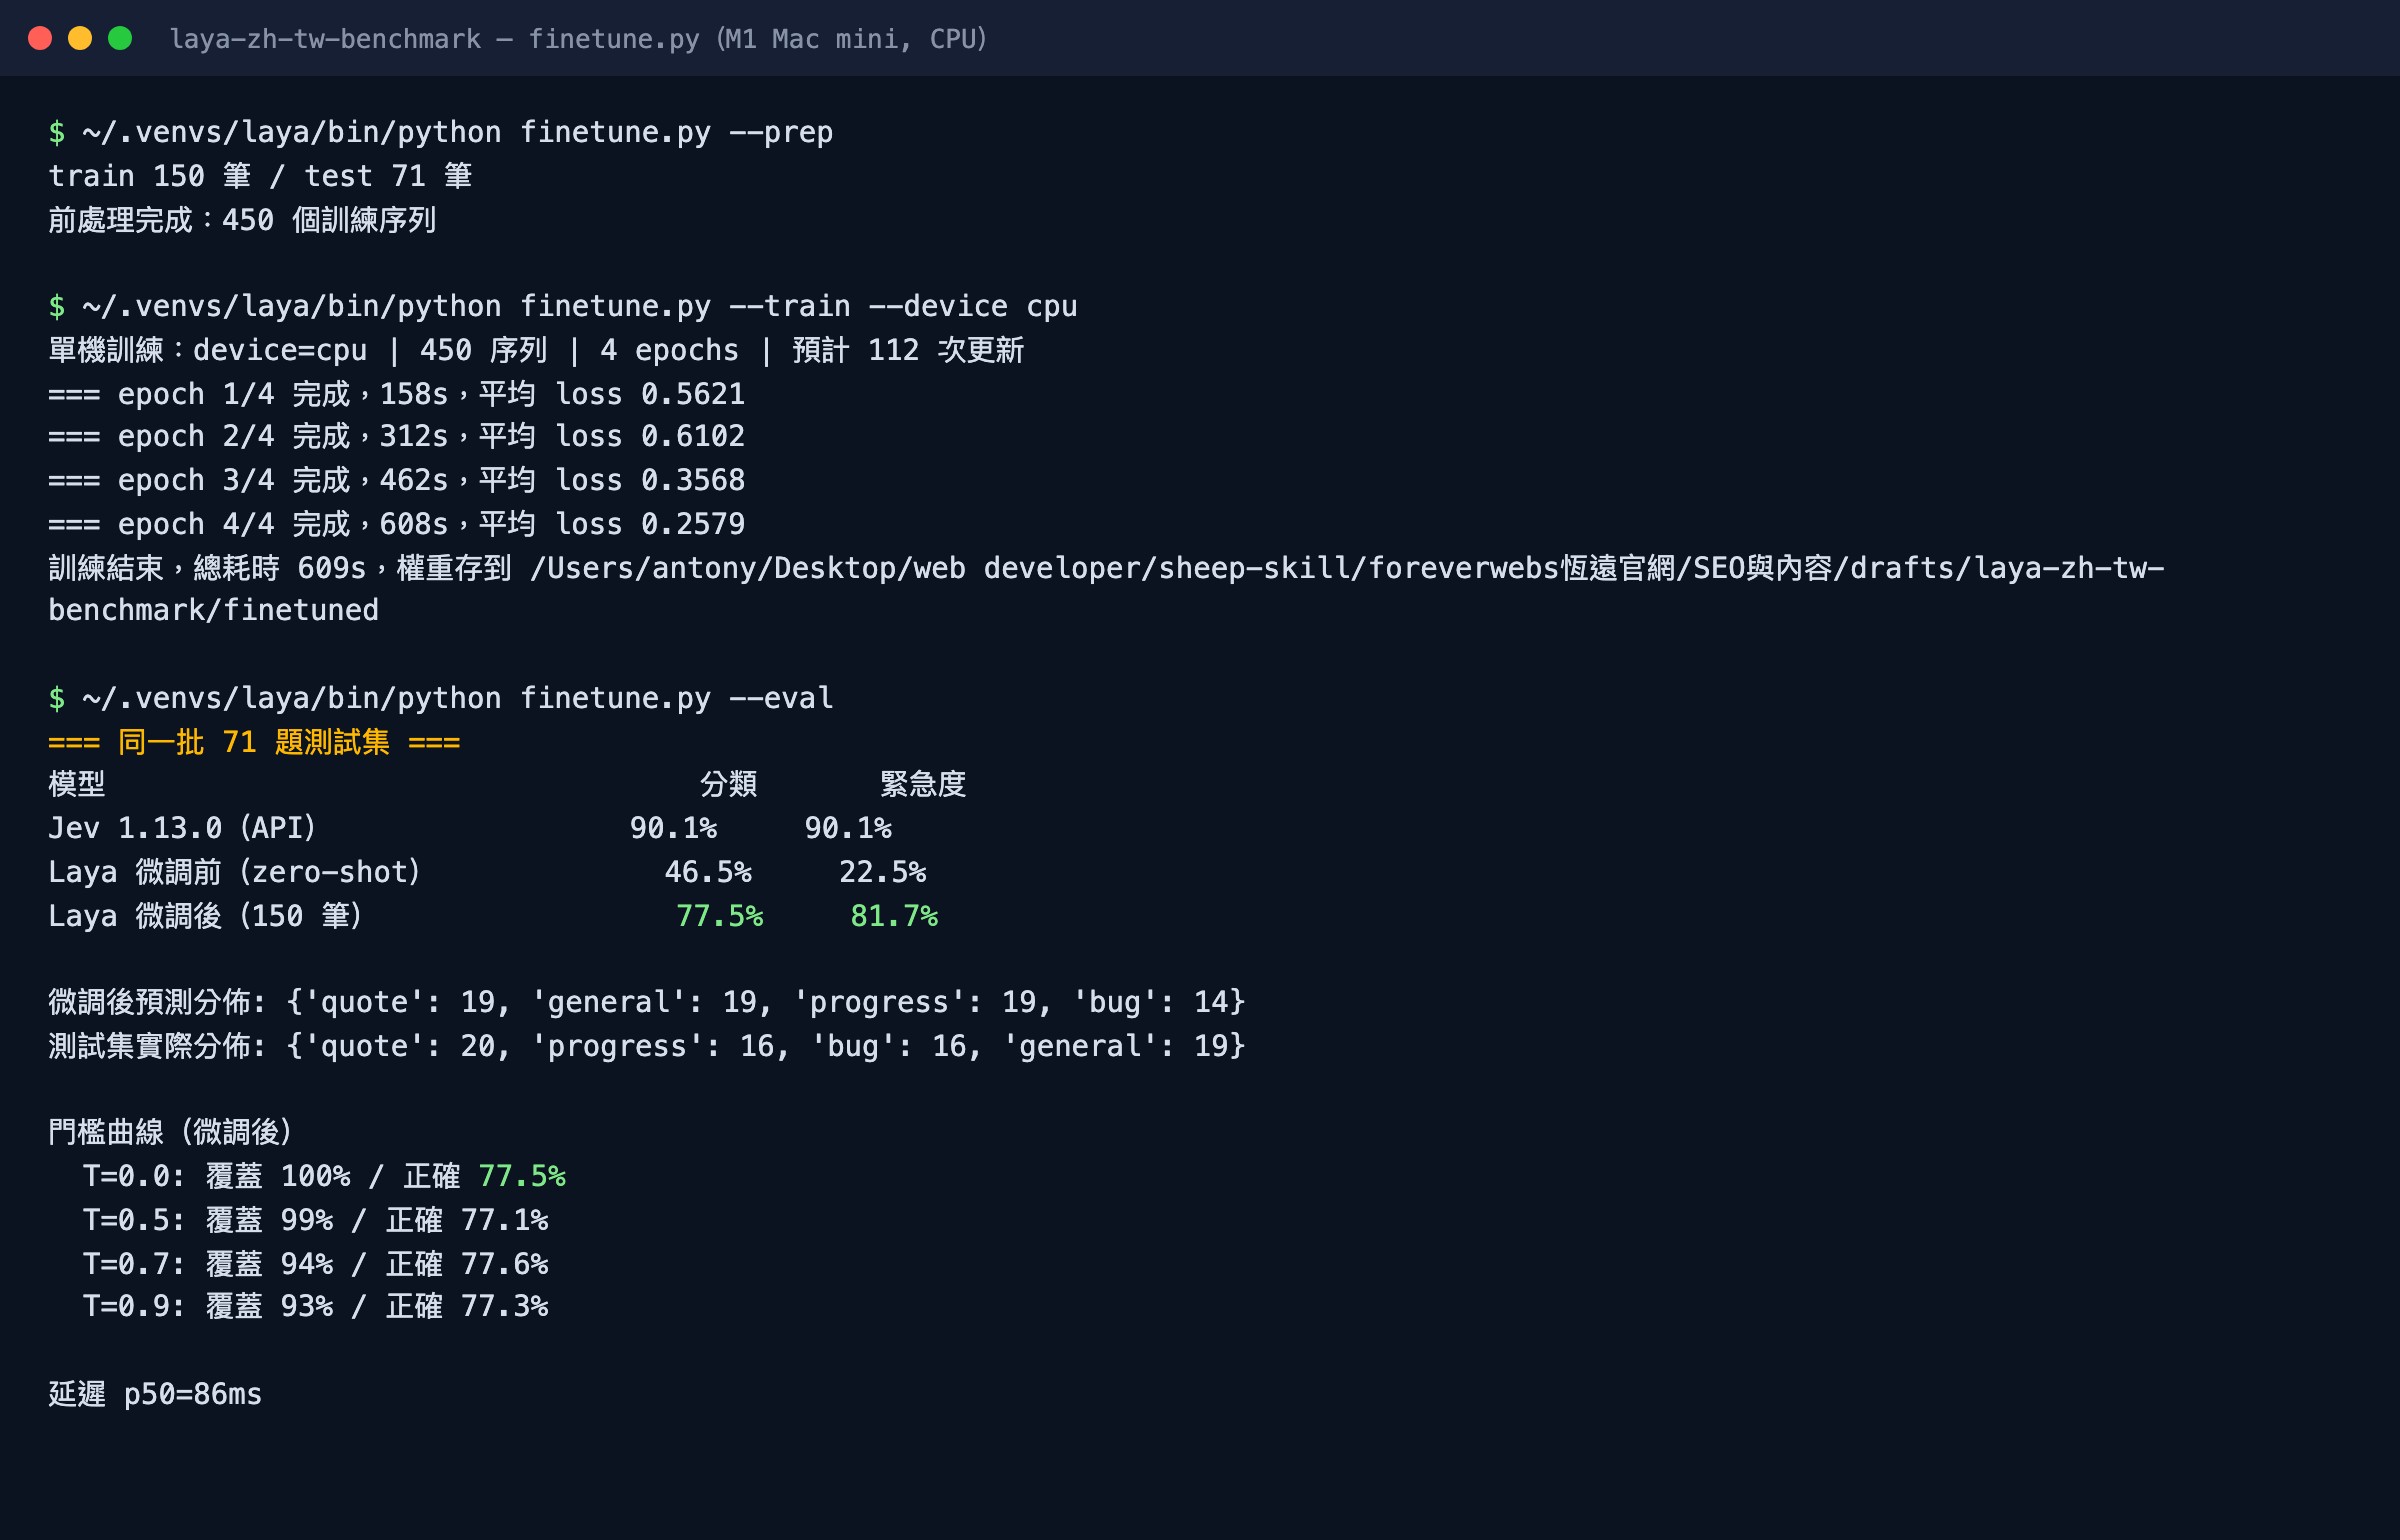
十分鐘這個數字值得停一下。一般人聽到「微調模型」會想到租顯示卡、跑好幾個小時、花好幾千塊。實際上這個規模的判斷模型,用一台沒有獨立顯示卡的桌機,午休時間就跑完了。真正的成本從頭到尾都是那 150 筆標註資料,那才是要人花時間的部分。
微調後:修好了塌陷,弄壞了信心
先給答案:準確率大幅提升,但信心門檻整個失去篩選能力。
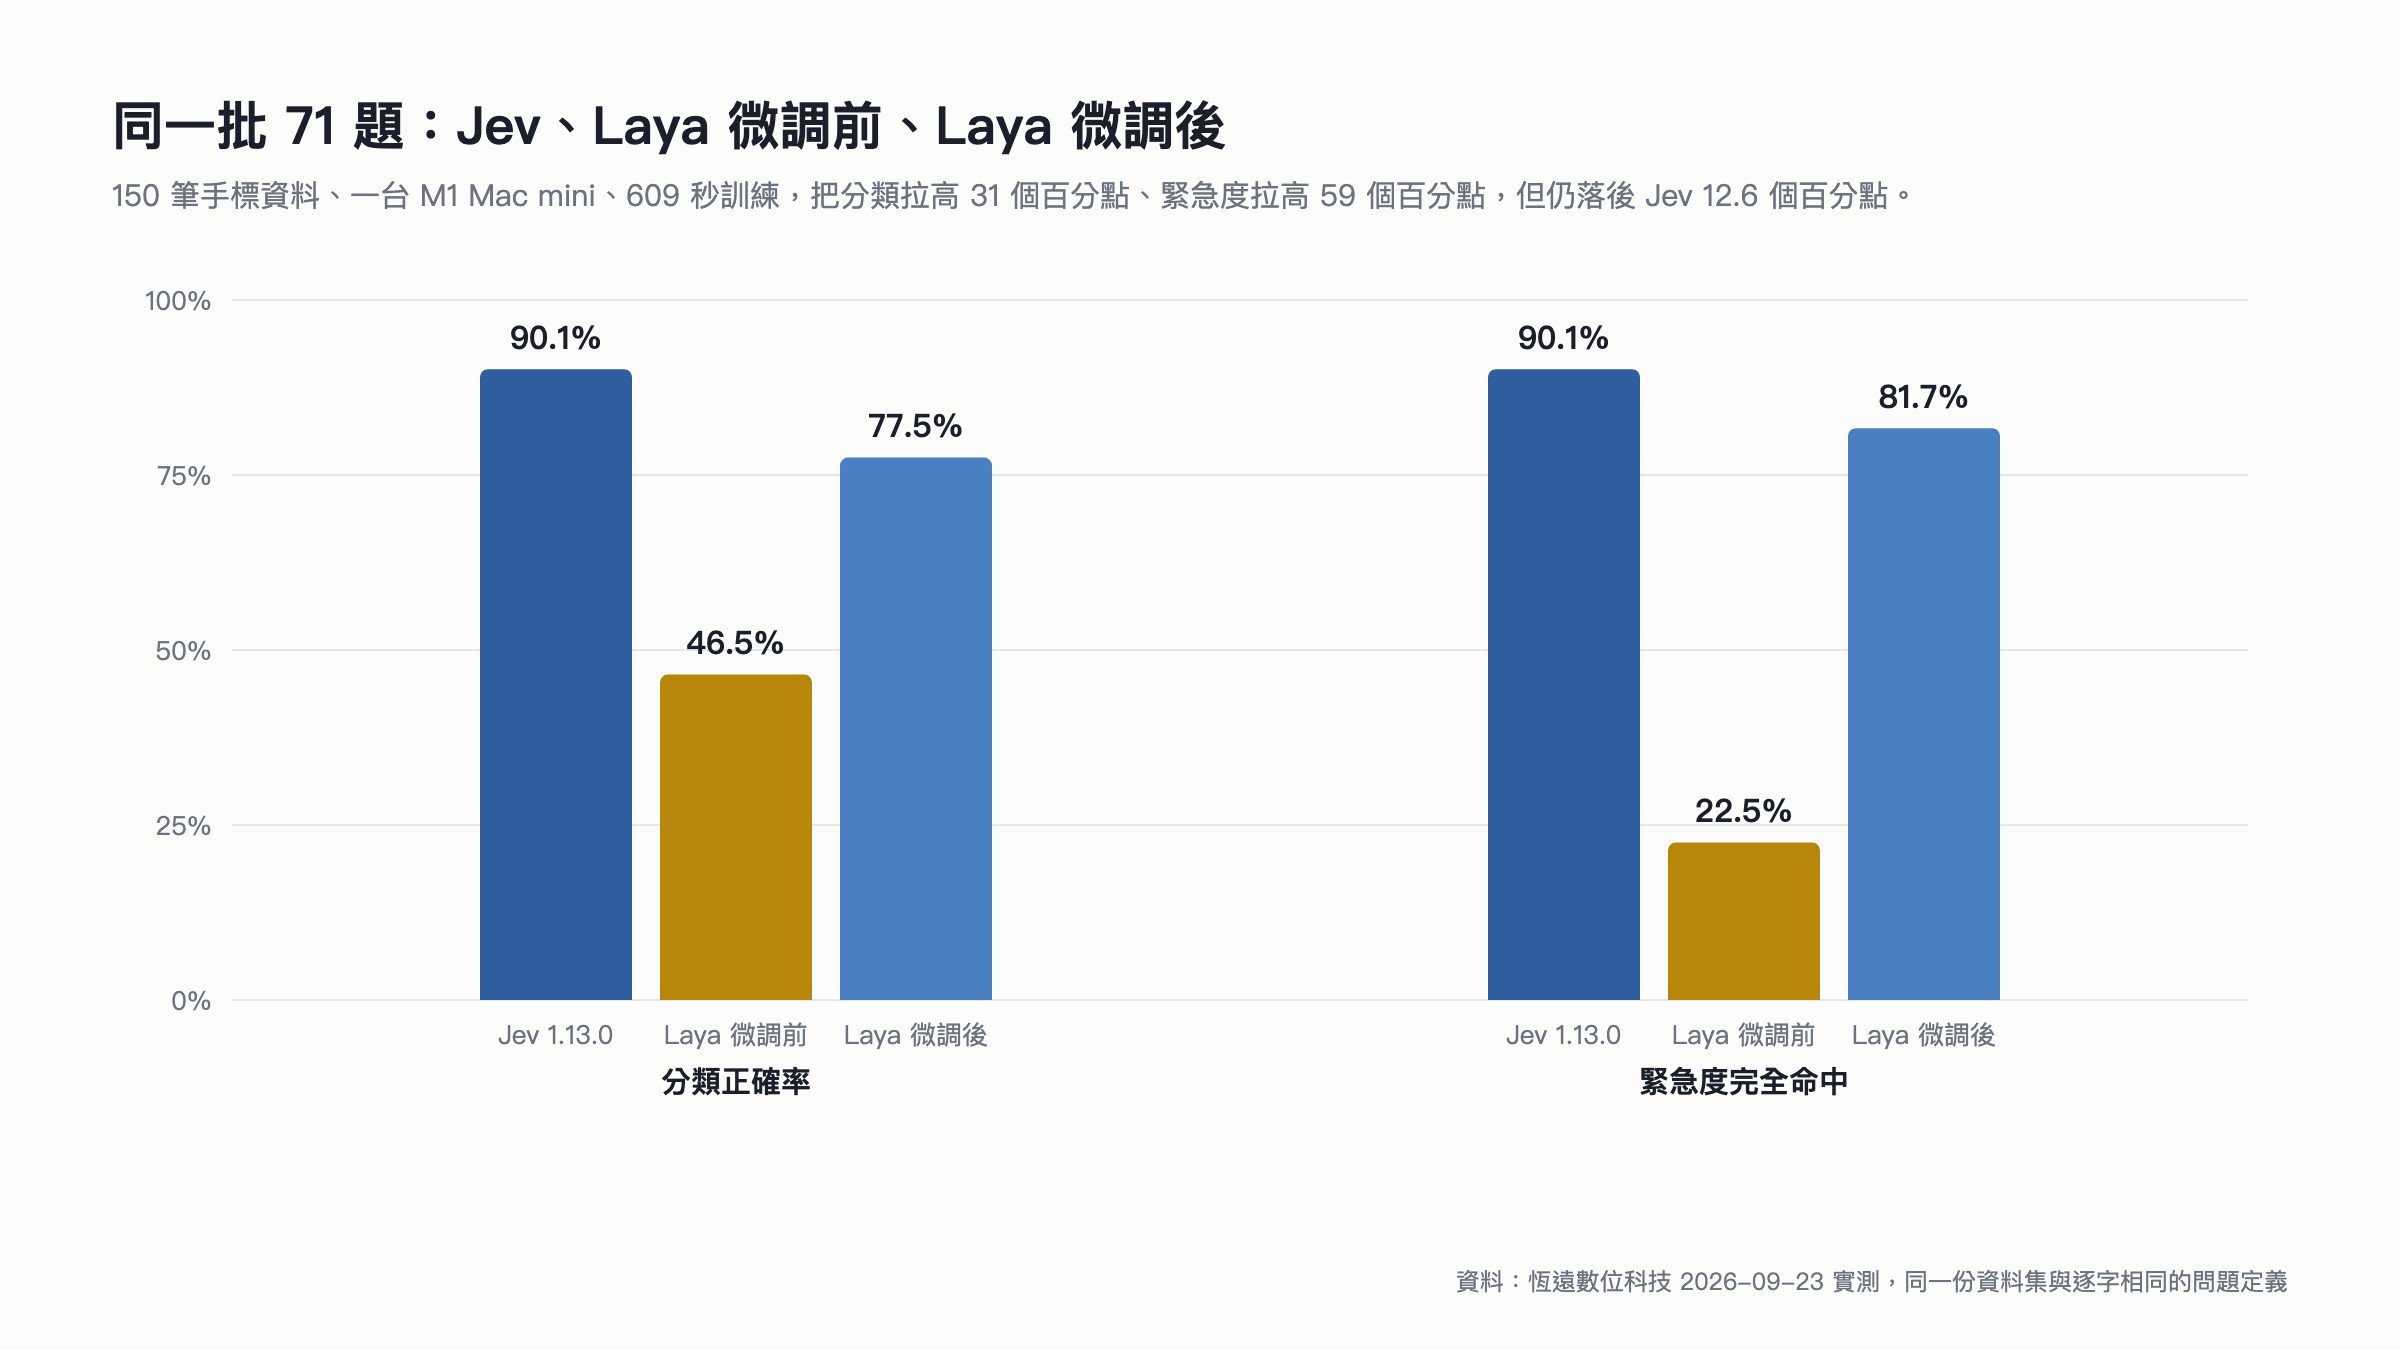
模型 | 分類正確率 | 緊急度完全命中 | 單題延遲 |
|---|---|---|---|
Jev 1.13.0(API) | 90.1% | 90.1% | 611 毫秒 |
Laya 微調前 | 46.5% | 22.5% | 86 毫秒 |
Laya 微調後 | 77.5% | 81.7% | 86 毫秒 |
最漂亮的改善是塌陷消失。微調前 221 筆有 140 筆倒向系統問題,微調後在 71 題測試集上的預測分佈是詢價 19、進度 19、一般詢問 19、系統問題 14,而實際分佈是 20、16、19、16。四個類別都回來了,這證明問題確實出在「模型沒學過這種任務的中文樣貌」,而不是它讀不懂繁體字。
但信心分數壞了
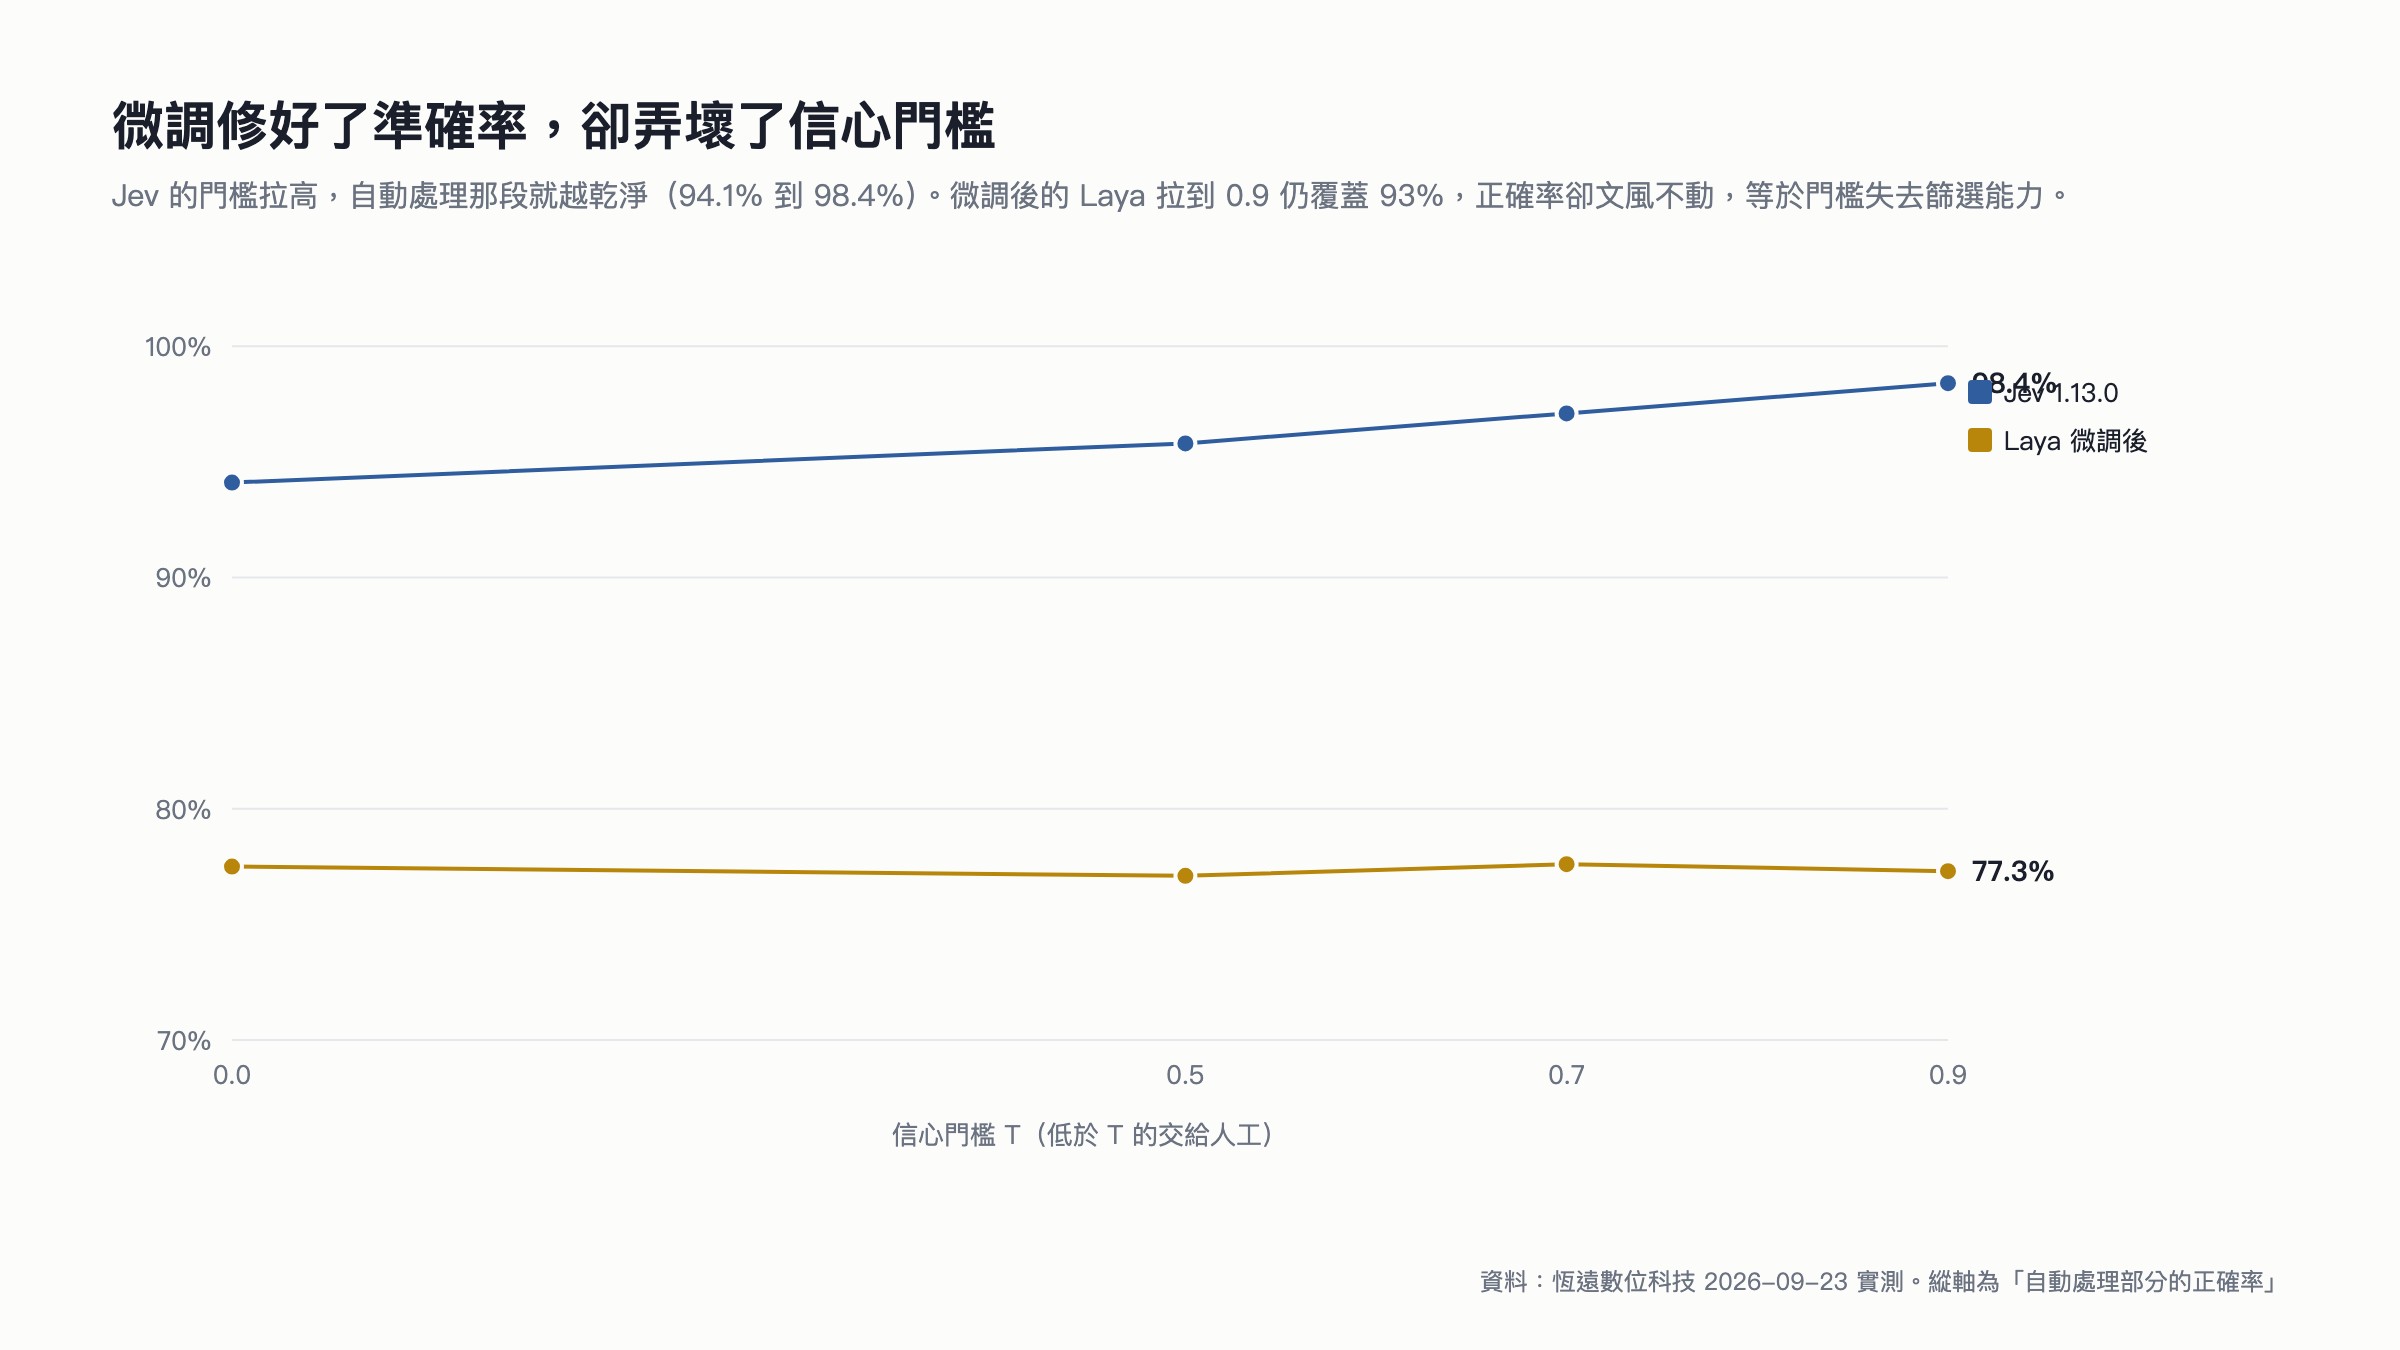
信心門檻 | Laya 微調後覆蓋率 | Laya 微調後正確率 | Jev 覆蓋率 | Jev 正確率 |
|---|---|---|---|---|
0.0 | 100% | 77.5% | 100% | 94.1% |
0.5 | 99% | 77.1% | 97% | 95.8% |
0.7 | 94% | 77.6% | 92% | 97.1% |
0.9 | 93% | 77.3% | 86% | 98.4% |
看最後一列:門檻拉到 0.9,Laya 還留著 93% 的題目,正確率卻停在 77.3% 文風不動;Jev 同樣門檻留下 86%,正確率升到 98.4%。信心門檻的作用是把「模型有把握的」跟「模型沒把握的」分開,微調後的 Laya 已經做不到這件事。
原因出在我們的訓練資料。我們用的是硬標籤,每一題只有對與錯兩種值,模型學到的就是「每題都給接近 1.0 的機率」。官方模型卡本來就警告過基礎版出廠偏過度自信、要自己重新校溫度,我們這輪微調反而把它推得更極端。要修的話得用帶機率分佈的軟標籤重訓,再做一次溫度校準,那是另一輪工程。
🚨這件事會讓自動分流不敢上線
信心門檻是整套自動化的安全閥。沒有它,你只能二選一:全部自動(接受兩成三的錯誤直接流到客戶端),或全部人工(那微調就白做了)。所以「微調後 77.5%」這個數字不能直接讀成「可以上線了」,它同時帶著一個必須先解決的副作用。
一個沒被弄壞的東西:速度
微調前後的延遲完全一樣,單題中位數都是 86 毫秒。這很合理,因為微調改的是權重的值,沒有改模型的大小與結構。所以「本機推論快 7 倍」這個優勢在整個實驗過程中都成立,它跟準確率是兩條獨立的軸。
這也解釋了為什麼網路上那些「開源模型在遊戲裡完勝」的示範看起來那麼誇張。即時場景每秒要做幾十次判斷,遠端 API 光是跨太平洋來回就吃掉幾百毫秒,本機模型贏的是架構,跟它判斷得準不準完全是兩件事。
這份實測對台灣團隊的實際意義
先給答案:開源模型的免費是真的,但它把成本從帳單搬到了標註資料與工程,而且搬過去的那部分比帳單貴。
你的情況 | 建議 |
|---|---|
客戶資料不能離開機房 | 值得自架。先準備 150 到 300 筆標註資料再動手 |
延遲必須壓在 100 毫秒內 | 值得自架。本機 86 毫秒對上跨海 611 毫秒是架構差距 |
只是想省 API 錢 | 先算清楚。我們實測 221 筆訊息的 API 成本是 0.0054 美元 |
還沒有標註資料 | 先用付費 API 把流程跑起來,順便累積資料 |
需要靠信心門檻自動分流 | 現階段付費 API 的校準品質明顯較好 |
分類選項超過 20 個 | 先拆成兩層粗到細,否則開源這條路會更吃力 |
再提醒一次那個最容易被忽略的前提:官方在Hugging Face 模型卡的「誠實的限制」那節,第一條就是「基礎 checkpoint 在零樣本上接近亂猜」,並直接寫明「Laya 是一個可以快速特化的底座,不是零樣本決策引擎」。我們這份繁中實測只是把那句話換算成台灣的資料而已,結論跟官方並不矛盾,矛盾的是中文圈的轉述。
我們自己的取捨是:客服分流流程的正式線繼續用付費 API 跑,因為它的即時性要求不高、而且信心門檻是我們兩條人工紅線的基礎。同時在本機留一份自架版本,等到「客戶資料不能出境」這種需求真的出現時才切換。上線後的監控照AI 客服模型 drift 治理那套,自架反而更需要,因為換版與重訓都在自己手上。
跟著這篇把 221 筆跑一次不難,難的是把它變成公司每天在用的東西。從「微調出 77.5%」到「客服主管每天真的少花一小時」之間,差的是一層客製:問題怎麼寫成短而互斥的選項、訊息怎麼清成乾淨的狀態、標註資料怎麼持續累積、人工複審那條路怎麼接回現有系統。少了這一層,它就是一個跑得很快的函式;有了這一層,它才是流程裡的一個節點。
不用一次到位,從你最頭痛的那一條流程開始就好。先聊一下你現在的情況,我們會直接告訴你「這個值得做嗎、大概怎麼做」,這個階段我們陪你一起想,後面真的要動手再談範圍跟費用。可以把你公司現在的流程丟過來,我們很樂意聽你聊聊現況,一起看看哪幾個判斷點適合先拆出來。
我們怎麼看:先量再選,不要先選再找理由
ℹ️我們怎麼看
這輪實測最值得帶走的其實是「拿自己的資料跑一次」這個動作的性價比,44.8% 與 77.5% 這兩個數字反而是其次。整份實驗從安裝到微調完成,花的錢是零、時間是一個晚上,換到的是一組沒有人能替你回答的答案:這個模型在你的客戶說的話上表現如何。我們的判斷是,未來兩年會有越來越多這種小而專的判斷模型出現,選型的成本會低到每個團隊都該自己量;真正稀缺的一直都是那份標好的資料,模型反而隨時有得換。對中小企業老闆來說,現在最值得做的一件事是:把過去三個月的客服訊息挑 200 筆出來標好,那份資料在你換任何模型時都能用,而模型三個月就換一輪。
我們也要誠實講這份實驗的限制。測試集只有 71 題,一題就是 1.4 個百分點,所以 77.5% 這個數字的誤差不小;訓練資料只有 150 筆,很可能有過擬合;而且我們沒有做軟標籤與溫度校準,那會改變信心分數那一節的結論。這些都寫在腳本與原始回應裡,完整資料與腳本在這裡,換成你自己的訊息就能重跑。
如果你想看更大規模的自架題目,企業自建大型語言模型的技術路徑那篇談的是完全不同量體的工程;想知道各種 AI 導入型態的費用級距,AI 導入成本拆解有三個預算區間的對照。
我們公司內部最省時間的三個 AI 流程,八成中小企業都用得上,而且它們的核心全部是選擇題。你公司現在最頭痛的是哪一塊?可以把現況丟過來,我們陪你一起看看適合的解法。
ℹ️我們做過這件事
順帶說一下,這篇的分流架構我們公司自己每天都在跑,目前內部有 20+ 個 AI 流程在工作中,客服分流就是其中一條,這份 221 筆資料集當初就是對著那條流程的三層設計出來的。我們自己每天在用的 SalesKing,AI 讀完 LINE 對話判斷客戶處在哪個銷售階段,那一層判斷跟本文的四選一是同一種題目。看到這裡,如果你也在想「這套放在我們公司會是什麼樣子」,我們很樂意聽你聊聊現在的實際情況,一起看看哪些做得起來、能從哪一塊開始。
AI 導入評估表下載
還沒決定該從哪個流程開始的話,這份評估表把「判斷點盤點、資料就緒度、風險等級」三件事做成可以自己填的表格,填完你會知道公司裡哪幾題選擇題最值得先讓 AI 接手。下載 AI 導入評估表(PDF)
QLaya 的繁體中文表現如何?
零樣本分類正確率 44.8%(221 筆台灣客服訊息、四類),而亂猜是 25%、永遠猜最大類是 27.6%。最嚴重的症狀是類別塌陷:221 筆有 140 筆被判成同一類,60 筆一般詢問只判對 1 筆。同一批資料 Jev 是 94.1%。
Q為什麼把選項描述寫得更詳細反而更差?
Laya 的所有選項共用一個固定的 token 預算(多語言版 256),描述越長每個選項分到的空間越少,選項之間就越難區分。我們把 Jev 那輪有效的詳細版換上去,正確率從 44.8% 掉到 26.7%。這跟官方揭露的 Banking77 弱項是同一個機制。
Q微調 Laya 要花多少時間跟錢?
我們用 150 筆手標訊息、在一台 M1 Mac mini 的 CPU 上跑四個 epoch,總共 609 秒、0 元,不需要任何雲端帳號。官方的雙 T4 notebook 訓練那格標的是四到六分鐘。真正的成本是準備標註資料的人力。
Q微調後就可以取代付費 API 了嗎?
還不行。微調後在同一批 71 題上分類 77.5%、緊急度 81.7%,仍落後 Jev 的 90.1%;更關鍵的是信心校準壞掉了,門檻拉到 0.9 仍覆蓋 93% 而正確率不動,等於自動分流的安全閥失效。要修得用軟標籤重訓加溫度校準。
Q在 M1 Mac mini 上跑 Laya 的實際速度是多少?
純 CPU 推論單題中位數 86 毫秒、九成在 91 毫秒以內,比官方給的 CPU 區間(193 到 464 毫秒)快一倍多,也比我們量到的 Jev 從台北呼叫的 611 毫秒快 7 倍。模型首次載入約 35 秒,之後常駐就穩定。
Q什麼情況才值得自架開源決策模型?
兩種:客戶資料不能離開自己的機房,或者延遲必須壓在 100 毫秒內。單純想省 API 費用通常划不來,我們實測 221 筆訊息的 API 成本只有 0.0054 美元。手上還沒有標註資料的話,先用付費 API 把流程跑起來會快很多。
讀到這裡,你手上應該有一組可以直接套用的判斷標準了。想知道換成你的客戶訊息會跑出什麼數字、或者這層判斷該怎麼接進現有的 CRM 與自動化流程,跟我們聊聊你的 AI 導入需求,我們會先幫你看哪一題最值得先動、大概怎麼做最划算,再談要不要真的動手。
AUTHOR
恆遠數位編輯團隊
想了解更多?看看我們的相關服務
需要網站系統架設或軟體開發?
無論是品牌官網、客製化系統還是應用程式,我們的團隊擁有豐富經驗,歡迎聯繫我們,讓專業為您的事業加分。
留言(0)
尚無留言,成為第一個留言的人吧!