開源 AI 模型比較,網路上大多是英文榜單。台灣企業真正要處理的,卻是 LINE 客服訊息、報價單、統一發票和民國年。榜單上的名次,很難直接回答「這個模型懂不懂台灣客人在說什麼」。
所以我們自己出題、自己測。2026 年 10 月 13 日,我們在政府提供的 AI 算力平台上,用同一批台灣題目測了 16 個開源語言模型。考卷共 99 題,其中 10 題看圖只考 8 個模型,總共 1,504 次呼叫,全部成功。另外也測了語音轉文字、文字轉語音和向量檢索模型。
這 16 個模型都公開了權重,可以下載到自己的主機執行。例如 OpenAI 的 gpt-oss、Google 的 Gemma 4,以及國研院的 TAIDE。平台規定不能使用中國或中資的模型,所以名單裡沒有 DeepSeek、Qwen 這類模型。想了解它們,可以看我們整理的中國四家開源 LLM 動向。
先給結論:綜合成績的第一群是 gpt-oss-120b、Nemotron 3 Ultra、Nemotron 3 Super、Gemma 4 31B、gpt-oss-20b,總分都在 93% 到 94% 之間,答對題數最多只差 3 題。不同用途的成績最高者不一樣,下表是快速對照。
用途 | 成績最高的模型 | 一句話提醒 |
|---|---|---|
綜合(9 個面向平均) | gpt-oss-120b、Nemotron 3 Ultra、Nemotron 3 Super、Gemma 4 31B、gpt-oss-20b(93% 到 94%) | 其中 4 個是推理模型,輸出 token 比較多 |
繁體中文與台灣用語 | Nemotron 3 Ultra 100% | 有 9 個模型會寫出「視頻、反饋」這類大陸用語 |
台語理解 | 6 個模型 100%(含 TAIDE) | 「好額」(有錢)只有 7 個模型答對 |
商業計算 | gpt-oss-120b、gpt-oss-20b、Nemotron 3 Super 100% | 多步驟報價只有 3 個模型算對 |
寫程式 | gpt-oss-120b、Nemotron 3 Ultra 100% | SQL 的 NULL 陷阱有 4 個模型中招 |
工具呼叫 | Gemma 4 31B、Nemotron 3 Super 100% | 9 個模型在沒有資料時自己編答案 |
看圖 | Llama 4 Maverick、Mistral Large 3 100% | gpt-oss、Llama 3、Nemotron 都只能讀文字 |
語音轉文字 | Whisper Large V3 加一句繁體提示 | 原樣輸出的關鍵資訊聽對 80%;不加提示約四分之一是簡體字 |
開源 AI 模型實測總表:16 個模型各適合做什麼
總分 90% 以上的第一群有 5 個:gpt-oss-120b、Nemotron 3 Ultra、Nemotron 3 Super、Gemma 4 31B、gpt-oss-20b。後段的模型也有自己的強項,要看你的用途。
模型(廠商) | 總分 | 強項 | 要注意 |
|---|---|---|---|
gpt-oss-120b(OpenAI,美國) | 94% | 計算、寫程式全對;工具呼叫 91% | 推理模型,每題平均輸出 337 token;沒資料時會自己編 |
Nemotron 3 Ultra(NVIDIA,美國) | 94% | 寫程式、繁中用語全對;計算 92% | 推理模型、不能看圖;沒資料時會自己編 |
Nemotron 3 Super(NVIDIA,美國) | 94% | 計算、工具呼叫全對;台語 92% | 兩題想太久,token 用完沒有回答 |
Gemma 4 31B(Google,美國) | 93% | 工具呼叫、台語全對;寫程式 92% | 多步驟計算會錯 |
gpt-oss-20b(OpenAI,美國) | 93% | 計算全對;工具呼叫 91%、台語 92% | 會留英文不翻、寫出「質量」,有一題想太久沒回答 |
Devstral 2(Mistral AI,法國) | 84% | 台語全對;工具呼叫 91%、格式 92% | 商業計算 58%、寫程式 67% |
Gemma 4 26B-A4B(Google,美國) | 84% | 台語全對;寫程式 92%、工具呼叫 91% | 長文被相似條文騙到,寫作字數控制差 |
Mistral Large 3(Mistral AI,法國) | 82% | 台語、看圖全對;格式 92% | 沒呼叫工具,卻回覆已排定 |
Llama 4 Maverick(Meta,美國) | 81% | 台語、看圖全對;繁中用語 92% | 工具呼叫用 Python 寫法,平台沒解析 |
Gemma 4 E4B(Google,美國) | 78% | 格式全對 | 寫程式 50%,常反問不呼叫工具 |
Mistral Small 3.2(Mistral AI,法國) | 74% | 格式 92% | 計算與寫程式只有一半 |
Llama 3.1 405B(Meta,美國) | 72% | 台語 92% | 工具參數的中文變成跳脫字元 |
Gemma 3 12B(Google,美國) | 71% | 台語 92%、格式 92% | 繁中 67%、寫程式 42%;工具題結果異常,不計分 |
Llama 3.3 70B(Meta,美國) | 68% | 格式 92% | 繁中 50%,計算 33%,客戶名稱寫錯字 |
TAIDE(國研院,台灣) | 68% | 台語全對;繁中用語 92%、格式 92% | 寫程式 17%,工具呼叫寫成文字 |
Phi-4 multimodal(Microsoft,美國) | 39% | 寫作 67% | 計算與寫程式都是 0%,會輸出簡體字;工具題結果異常,不計分 |
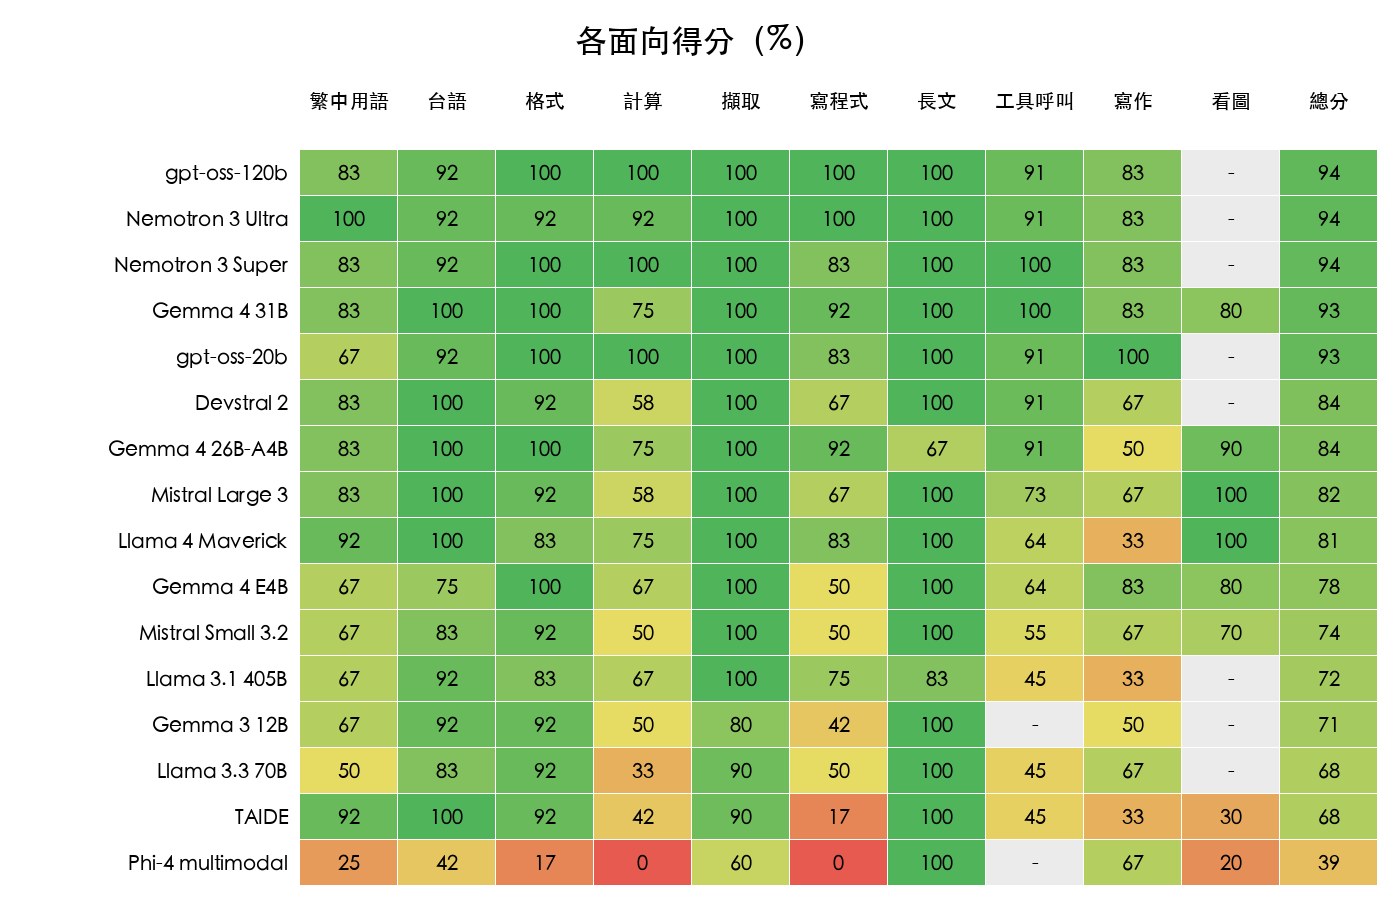
總分是看圖以外 9 個面向的平均,每個面向權重一樣。看圖只考了 8 個模型,放進總分對其他模型不公平,所以分開列。Phi-4 multimodal 與 Gemma 3 12B 的工具題結果異常,所以不計分,總分只算 8 個面向。
分數只代表這 99 題。每個面向 2 到 12 題,改成每題等權計算時,中段有幾組名次會對調。所以請看分群,不要看精確名次。為什麼公開榜單不能直接套用,可以看LLM Benchmark 解讀的 5 個原則。
16 個模型的廠商、規模與授權
嚴格來說,這些模型多半是「開放權重」:權重可以下載,訓練資料卻不一定公開。下表的規模與授權都取自官方 model card,查證日是 2026 年 10 月 13 日。
模型 | 廠商 | 參數量 | 授權 | 可以商用嗎 | 上下文長度 |
|---|---|---|---|---|---|
OpenAI,美國 | 1,170 億,每次啟用 51 億(MoE) | Apache 2.0 | 可以 | 128K | |
OpenAI,美國 | 210 億,每次啟用 36 億(MoE) | Apache 2.0 | 可以 | 128K | |
Google,美國 | 307 億 | Apache 2.0 | 可以 | 256K | |
Google,美國 | 252 億,每次啟用 38 億(MoE) | Apache 2.0 | 可以 | 256K | |
Google,美國 | 有效參數 45 億(含嵌入層共 80 億) | Apache 2.0 | 可以 | 128K | |
Google,美國 | 120 億 | Gemma 使用條款 | 可以,但要遵守 Google 的使用限制 | 128K | |
國研院,台灣 | 124 億(以 Gemma 3 12B 為底) | TAIDE 模型授權條款(Gemma 版) | 條款沒有禁止,但也沒有明寫可以;散布衍生模型要標示來源 | 128K | |
Meta,美國 | 4,050 億 | Llama 3.1 社群授權 | 可以;版本發布時月活躍用戶超過 7 億的公司要另外申請,產品要標示 Built with Llama | 128K | |
Meta,美國 | 700 億 | Llama 3.3 社群授權 | 可以;版本發布時月活躍用戶超過 7 億的公司要另外申請,產品要標示 Built with Llama | 128K | |
Meta,美國 | 4,000 億,每次啟用 170 億(MoE) | Llama 4 社群授權 | 可以;版本發布時月活躍用戶超過 7 億的公司要另外申請,產品要標示 Built with Llama;歐盟另有限制 | 1M | |
Mistral AI,法國 | 6,750 億,每次啟用 410 億(MoE) | Apache 2.0 | 可以 | 256K | |
Mistral AI,法國 | 240 億 | Apache 2.0 | 可以 | 128K | |
Mistral AI,法國 | 1,230 億 | 修改版 MIT | 全球月營收超過 2,000 萬美元的公司不能直接用,要另向 Mistral 取得商業授權 | 256K | |
NVIDIA,美國 | 1,200 億,每次啟用 120 億(MoE) | NVIDIA Nemotron 開放模型授權 | 可以 | 1M(預設 256K) | |
NVIDIA,美國 | 5,500 億,每次啟用 550 億(MoE) | OpenMDW 1.1 | 可以 | 1M(預設 256K) | |
Microsoft,美國 | 56 億 | MIT | 可以 | 128K |
總參數是整個模型的大小。MoE 架構每次只啟用一部分參數,所以另外列出「每次啟用」。上下文長度是官方規格,平台上能用的長度可能比較短。
各家授權差很多。Apache 2.0 和 MIT 最寬鬆,商用不用另外申請,gpt-oss、Gemma 4、Mistral Large 3 與 Small 3.2、Phi-4 都屬於這類。Llama 用 Meta 自訂的社群授權,版本發布時月活躍用戶超過 7 億的公司才要另外申請,產品則要標示 Built with Llama。最要小心的是 Devstral 2 的授權:公司全球月營收超過 2,000 萬美元就不能直接用,要另向 Mistral 取得商業授權。
語音與向量模型也要看授權。embeddinggemma-300m 用 Gemma 使用條款。Taiwan-Tongues-ASR-CE 用 TRAIL 授權:修改後的模型若要散布,必須一起公開;對外散布產出的內容時,也要標示是機器產生。
TAIDE 的授權條款沒有禁止商用,但也沒有明寫可以商用。它以 Gemma 3 為底,所以還要同時遵守 Google 的 Gemma 使用條款。要放進對外的商業產品,建議先寫信向 TAIDE 團隊確認。
還有一點容易被忽略:模型的出身,不能只看是哪家公司發布。NVIDIA 在 Nemotron 3 Super 與 Ultra 的 model card 都寫明,大量合成訓練資料是用 Qwen、DeepSeek 等中國公司的模型產生的,Super 的獎勵模型還以 Qwen3 初始化。模型本身由 NVIDIA 訓練。如果你的單位要求完全不能有中國來源,選型前要把 model card 讀完。
我們怎麼測:同一個平台、同一批台灣題目、同一套評分
16 個模型用同一個平台、同一份 99 題考卷、同一套自動評分程式,每題只問一次。題目全部是我們自己出的虛構資料,沒有用到任何真實客戶資料。
面向 | 題數 | 例題 | 怎麼判對錯 |
|---|---|---|---|
繁中與台灣用語 | 12 | 題目故意夾英文 software、video,看模型選什麼中文詞;台灣常識選擇題 | 不能有簡體字或大陸用語,英文照抄不翻也算錯;選擇題對答案 |
台語理解 | 12 | 「好額」「拄才」「下晡」是什麼意思;台語句子翻華語 | 選項或關鍵詞 |
照格式輸出 | 12 | 只回數字、純 JSON、Markdown 表格、剛好 5 點條列 | 格式完全符合才算對 |
商業計算 | 12 | 含稅未稅、打折抹零、匯率、分期、加班費 | 對數字 |
資訊擷取 | 10 | LINE 訊息、email、收據、會議紀錄抽成 JSON | 逐欄比對 |
寫程式 | 12 | 統編驗證、國字大寫金額、身分證驗證、2 題 SQL | 實際執行,測試全過才算對 |
長文閱讀 | 2 | 1.2 萬字與 4.5 萬字的規章,埋 3 個答案與相似條文 | 答對幾欄給幾分 |
工具呼叫 | 11 | 查報價單、排師傅、換匯;含「明天」「下週一」 | 叫對工具、參數正確 |
寫作限制 | 6 | IG 貼文剛好 3 個 hashtag、不能出現「抱歉」 | 字數、必含詞、禁用詞 |
看圖 | 10 | 銘牌、收據、長條圖、名片、劃掉改期的白板 | 對答案;只考 8 個模型(見下方說明) |
評分方式
評分全部由程式自動完成,同一份考卷、同一套規則。溫度設 0.3,每題每個模型只問一次。
程式題會把模型寫的程式放進隔離環境實際執行。用了 eval 這類危險寫法的,我們直接判錯,因為它在正式系統裡就是資安漏洞。
總分出來後,我們另外請一個沒參與出題的 AI 審查者,逐筆看過全部答錯的回答。判對的題目也抽查過。有幾題規則太嚴,例如台語「無閒」翻成「沒空」也是對的。也有幾題太鬆,例如模型自己編出公司上班時間。這些都已修正並重新計分。
寫作題只檢查字數、必含詞、禁用詞與台灣用語,不評文筆好壞。字數只算漢字,不算標點。
這些題目的設計,來自我們自己做產品的經驗。我們的產品秒發報價Pro有一項功能,是用一句話描述需求,由 AI 產生結構化的報價項目。資訊擷取、格式和計算題,就是照這類需求出的。
這份測試的限制
- 題目是我們自己出的,每個面向題數不多,適合看明顯差距,不適合排精確名次。
- 每題只問一次。同一個模型再問一次,偶爾會有不同答案。
- 速度包含網路與平台排隊時間,代表在這個平台上的體感,不是模型本身的極限。
- 語音是電腦合成的聲音,比真人錄音乾淨。台語語音這次沒有測。
- 官方支援看圖的 8 個模型考了 7 個,Gemma 3 12B 只當 TAIDE 的對照組,沒有考看圖。TAIDE 官方建議只輸入文字,我們仍讓它試考。
- Phi-4 multimodal 與 Gemma 3 12B 的 11 題工具呼叫結果異常,所以不計分。
- 模型版本更新很快,這是 2026 年 10 月 13 日的快照。模型的規模、授權與硬體需求,也是同一天查證的官方資料。
如果你想用自己的題目做一次評測,方法可以參考LLM Evals 完整指南。我們之前也用同樣的方法測過繁體中文分類模型。
繁體中文與台灣用語:誰會混進簡體字和大陸用語
繁中用語成績最高的是 Nemotron 3 Ultra(100%),Llama 3.3 70B 只有 50%,Phi-4 multimodal 更只有 25%。在繁中題與寫作題裡,大陸用語是最常見的錯,簡體字反而少見。
我們在題目裡故意夾英文,例如請模型介紹一台有 16GB memory、可以 print 文件的筆電。這時候模型要自己選中文詞,台灣用語的功力就看得出來。
模型 | 繁中分數 | 寫出的大陸用語或簡體字(含寫作題) | 英文照抄沒翻 |
|---|---|---|---|
Nemotron 3 Ultra | 100% | 沒有 | 沒有 |
Llama 4 Maverick | 92% | 「質量」「反饋」 | 沒有 |
TAIDE | 92% | 「質量」「營銷」 | 沒有 |
gpt-oss-120b | 83% | 沒有 | server、database、video |
Mistral Large 3 | 83% | 「反饋」 | 沒有 |
Devstral 2 | 83% | 「運營」「反饋」 | feedback |
Gemma 4 31B | 83% | 沒有 | 沒有 |
Gemma 4 26B-A4B | 83% | 沒有 | 沒有 |
Nemotron 3 Super | 83% | 沒有 | server、database、video |
gpt-oss-20b | 67% | 「質量」 | activate、default |
Llama 3.1 405B | 67% | 「視頻」「打印」「反饋」 | 沒有 |
Mistral Small 3.2 | 67% | 「質量」 | server、database、video |
Gemma 4 E4B | 67% | 沒有 | 沒有 |
Gemma 3 12B | 67% | 沒有 | 沒有 |
Llama 3.3 70B | 50% | 「反饋」「視頻」「打印」「硬盤」 | 沒有 |
Phi-4 multimodal | 25% | 整句簡體字,另有「信息」「質量」「運營」「人工智能」 | server、database、backup、video |
比較意外的是,成績很好的模型也會「偷懶」:gpt-oss-120b、Nemotron 3 Super、gpt-oss-20b 都有一題把 server、activate 這類英文詞原封不動留著。給客戶看的公告留著英文,在台灣也不算合格。
幾個實際例子:Llama 3.1 405B 把 video 寫成「視頻」、print 寫成「打印」。Llama 4 Maverick 介紹除濕機時寫「改善空氣質量」,台灣會說「空氣品質」。Phi-4 multimodal 回覆客戶的一段話,整句都是簡體字。
其他題型也看得到簡體字:gpt-oss-20b 和 Devstral 2 的台語翻譯整句是簡體,Llama 4 Maverick 看圖題的解題說明也是簡體。這幾題沒有扣分,因為台語翻譯評分前會先轉成繁體,看圖題只核對答案數字。
「土豆」是什麼?16 個模型只有 3 個答對
我們問:在台灣的日常口語裡,「土豆」通常指什麼?台灣說的土豆是花生。16 個模型裡只有 Llama 4 Maverick、TAIDE、Nemotron 3 Ultra 答對,其他都選了馬鈴薯,也就是大陸的用法。
這題很小,但很能說明問題:訓練資料裡大陸的用法很可能比較多。做台灣客服或在地內容,上線前一定要用台灣的題目測過。
TAIDE 和 Google 官方的 Gemma 3 12B 差在哪
TAIDE 是國科會推動、國研院開發的台灣語言模型。這次測的版本,是從 Google 的 Gemma 3 12B 預訓練模型調校出來的。Google 也用同一個底座,調出官方的對話版 Gemma 3 12B。我們把兩個放在同一份考卷上,看台灣調校換到了什麼。
面向 | TAIDE | Gemma 3 12B(Google 官方版) |
|---|---|---|
繁中用語 | 92% | 67% |
台語 | 100% | 92% |
格式 | 92% | 92% |
計算 | 42% | 50% |
擷取 | 90% | 80% |
寫程式 | 17% | 42% |
長文 | 100% | 100% |
寫作 | 33% | 50% |
8 個面向平均(不含工具與看圖) | 71% | 71% |
TAIDE 的繁中用語多對 3 題,台語多對 1 題;寫程式卻少對 3 題。8 個面向平均起來,兩者都是 71%。
工具呼叫沒辦法比:Google 官方版的工具題結果異常,所以不計分。TAIDE 自己的工具呼叫常寫成一般文字,平台沒辦法轉成系統能執行的指令。
所以 TAIDE 適合放在「要說台灣話」的位置,例如客服回覆的潤飾。計算和串接系統交給其他模型。Gemma 系列的背景可以看Gemma 3 完整指南與Gemma 4 自架評估。
台語:文字題 6 個模型全對,語音還要真人錄音才能測
台語文字理解比預期好,6 個模型 12 題全對,包括 Llama 4 Maverick、Mistral Large 3、Devstral 2、Gemma 4 31B、Gemma 4 26B-A4B、TAIDE。成績最低的是 Phi-4 multimodal(42%)。
最難的是「伊足好額」的「好額」,意思是很有錢。16 個模型只有 7 個答對,多數選了「很好看」。
翻譯題也看得出差異。題目是「伊這馬無閒,下晡才會當來」。多數模型翻成「他現在很忙,下午才能來」,或「他現在沒空,下午才會來」,兩種都對。Gemma 4 E4B 把「這馬」原封不動留著,Phi-4 multimodal 幾乎原封不動把原句抄回來。
要注意,這次只測了台語文字。台語語音辨識需要真人錄音,我們會在下一階段補上。到時也會用台語錄音測聯發科與陽明交大的 Breeze-ASR-26,這次先用華語錄音測過,結果在下方語音段落。語音轉文字的服務比較,可以先看語音轉錄 API 比較。
格式輸出、商業計算與資訊擷取:接進系統最先卡關的三件事
資訊擷取最穩,12 個模型全對;格式輸出大多過關;只准直接給答案時,商業計算是多數模型的弱點。
模型 | 照格式輸出 | 商業計算 | 資訊擷取 |
|---|---|---|---|
gpt-oss-120b | 100% | 100% | 100% |
Nemotron 3 Ultra | 92% | 92% | 100% |
Nemotron 3 Super | 100% | 100% | 100% |
Gemma 4 31B | 100% | 75% | 100% |
gpt-oss-20b | 100% | 100% | 100% |
Devstral 2 | 92% | 58% | 100% |
Gemma 4 26B-A4B | 100% | 75% | 100% |
Mistral Large 3 | 92% | 58% | 100% |
Llama 4 Maverick | 83% | 75% | 100% |
Gemma 4 E4B | 100% | 67% | 100% |
Mistral Small 3.2 | 92% | 50% | 100% |
Llama 3.1 405B | 83% | 67% | 100% |
Gemma 3 12B | 92% | 50% | 80% |
Llama 3.3 70B | 92% | 33% | 90% |
TAIDE | 92% | 42% | 90% |
Phi-4 multimodal | 17% | 0% | 60% |
多步驟計算:16 個模型只有 3 個算對
這題是一張報價單:網站設計 45,000 元、主機一年 6,000 元、維護費每月 1,500 元簽 12 個月,加總後打 9 折,再加 5% 營業稅。答案是 65,205 元。
只有 gpt-oss-20b、gpt-oss-120b、Nemotron 3 Super 算對。其他模型的答案從 3 萬多元到 20 萬元都有,差距很大。
原因不難理解。題目要求只回答數字,不讓模型列算式。推理模型會先在內部算一遍,一般模型只能心算。結果 4 個推理模型有 3 個算對,12 個一般模型全錯。
我們的看法很直接:報價金額不要交給語言模型心算。讓模型負責把客人的話拆成品項和數量,金額交給程式計算,再讓人確認。
格式:字數限制和民國年最常出錯
格式題的錯大多很具體。要求一句話 30 字以內,Llama 3.1 405B、Llama 4 Maverick、Mistral Large 3 寫到 31 到 48 字。民國年換成西元,有模型把 114 年算成 2023 或 2024 年。Mistral Small 3.2 列「三種小吃」,三行都寫蚵仔煎。
這些小問題,串接系統時都要在程式端多做一層檢查,例如驗證字數、日期格式和重複值。
如果你在評估要不要用微調解決這類問題,可以先看Fine-tuning 與 RAG 怎麼選。
寫程式、長文閱讀與工具呼叫:開源模型能不能當系統的大腦
寫程式只有 gpt-oss-120b、Nemotron 3 Ultra 12 題全對。長文閱讀幾乎都過關,16 個模型都讀完了 4.5 萬字的規章。工具呼叫只有 Gemma 4 31B、Nemotron 3 Super 全對。
模型 | 寫程式 | 長文閱讀 | 工具呼叫 |
|---|---|---|---|
gpt-oss-120b | 100% | 100% | 91% |
Nemotron 3 Ultra | 100% | 100% | 91% |
Nemotron 3 Super | 83% | 100% | 100% |
Gemma 4 31B | 92% | 100% | 100% |
gpt-oss-20b | 83% | 100% | 91% |
Devstral 2 | 67% | 100% | 91% |
Gemma 4 26B-A4B | 92% | 67% | 91% |
Mistral Large 3 | 67% | 100% | 73% |
Llama 4 Maverick | 83% | 100% | 64% |
Gemma 4 E4B | 50% | 100% | 64% |
Mistral Small 3.2 | 50% | 100% | 55% |
Llama 3.1 405B | 75% | 83% | 45% |
Gemma 3 12B | 42% | 100% | - |
Llama 3.3 70B | 50% | 100% | 45% |
TAIDE | 17% | 100% | 45% |
Phi-4 multimodal | 0% | 100% | - |
寫程式:台灣規則最容易出錯
10 題 Python 多數是台灣常見的商業規則,例如統一編號驗證、國字大寫金額、身分證字號驗證。題目把規則寫清楚,考的是照規格實作的能力。
最難的是國字大寫金額,例如 1,005 要寫成「壹仟零伍元整」。只有 4 個模型通過全部測試。SQL 題設了一個陷阱:客戶編號有空值時,用 NOT IN 會查不到任何資料。4 個模型掉進這個陷阱。
推理模型偶爾會想太久:Nemotron 3 Super、gpt-oss-20b 有題目把 6,144 個輸出 token 全用在思考,最後沒有產出答案。專為寫程式設計的 Devstral 2,在我們的台灣題目上拿到 67%,沒有比通用模型突出。寫程式的模型要用自己的程式碼庫再測一次。
長文:4.5 萬字的規章全部讀得完
長文題是一份虛構的公司規章,約 4.5 萬字,換算成 token 大約 2.8 萬到 4.7 萬。裡面埋了 3 個答案,也放了相似的干擾條文。
16 個模型都沒有超過長度限制。只有 Llama 3.1 405B 和 Gemma 4 26B-A4B 被干擾條文騙到,把「驗收延誤補償」條文的千分之一或千分之一點五,當成逾期罰則的數字。
工具呼叫:六種常見的失敗
工具呼叫是讓模型「動手做事」的關鍵,例如查庫存、排師傅。失敗的方式比答錯更值得注意:
- 沒資料時自己編:問「公司幾點上班」,系統裡沒有這項資料。能正常考工具的 14 個模型裡,9 個直接編出時間,例如 gpt-oss-120b 回答「上午 8:30 開始,下午 5:30 下班」。Nemotron 3 Super、Gemma 4 26B-A4B、Gemma 4 31B、Gemma 4 E4B 老實說沒有資料;TAIDE 沒有編造,但反問要呼叫哪個工具。
- 沒呼叫卻說做完了:Mistral Large 3 被要求排到府丈量時,沒有呼叫工具,卻回覆「行程已經排定」。
- 格式平台讀不懂:Llama 4 Maverick 有 3 題其實寫出了正確的呼叫,但用的是 Python 函式寫法,平台沒有轉成工具指令。自己架設時,換用支援這種寫法的解析器應該就能解決,我們沒有實測。
- 寫成一般文字:TAIDE 把呼叫內容寫在回覆文字裡,系統無法執行。
- 參數變亂碼:Llama 3.1 405B 把中文參數寫成跳脫字元,Llama 3.3 70B 把「王先生」寫成「王克生」、「高雄」寫成「高海」。
- 多問一次:Gemma 4 E4B 等模型在資訊已經足夠時,還反問客戶名稱或數量。
另外,Phi-4 multimodal 與 Gemma 3 12B 的 11 題工具呼叫結果異常,所以不計分,表中以「-」表示。
要讓模型串接公司系統,工具呼叫的穩定度比聊天能力重要。系統提示詞要寫清楚「沒有資料就說沒有」,並在程式端檢查參數。MCP 這類標準怎麼運作,可以看MCP 是什麼。
看圖與語音轉文字:多模態開源模型的實際水準
看圖由 Llama 4 Maverick、Mistral Large 3 拿到 100%;語音轉文字建議用 Whisper Large V3,並加一句繁體中文提示。
模型 | 看圖(10 題) | 最常錯的地方 |
|---|---|---|
Llama 4 Maverick | 100% | 全對 |
Mistral Large 3 | 100% | 全對 |
Gemma 4 26B-A4B | 90% | 數錯紅色圓形 |
Gemma 4 31B | 80% | 長條圖加總、數形狀 |
Gemma 4 E4B | 80% | 長條圖加總、數形狀 |
Mistral Small 3.2 | 70% | 收據金額、長條圖、數形狀 |
TAIDE | 30% | 官方建議只輸入文字;銘牌電流、長條圖、價目表、名片、表單都讀錯 |
Phi-4 multimodal | 20% | 型號、收據、名片、白板多題讀錯 |
銘牌、收據、價目表這類文字清楚的圖,多數模型讀得出來。最容易錯的是數東西和讀圖表數字:數圖中有幾個紅色圓形,8 個模型只有 2 個答對。
白板題把舊的會議時間劃掉,改寫新時間。成績好的模型都抓到了新時間,不會被劃掉的字誤導。單據辨識的系統做法,可以參考企業 OCR 系統的 5 種做法。
語音轉文字:Whisper Large V3 加一句提示,簡體字幾乎歸零
我們用電腦語音念了 8 句商務對話,例如「麻煩改到下週二下午兩點」。每句分成乾淨女聲、合成男聲和加噪音三種,看關鍵資訊有沒有聽對。「原樣輸出」是模型直接給的文字;「簡轉繁後」是先把簡體字換成繁體再比對,看的是聽得準不準。
設定 | 關鍵資訊聽對(原樣輸出) | 關鍵資訊聽對(簡轉繁後) | 簡體字占比(以字計) | 字錯率(簡轉繁後) | 乾淨女聲/合成男聲/加噪音(簡轉繁後) |
|---|---|---|---|---|---|
Whisper-Large-V3 | 51% | 83% | 26% | 27% | 90%/69%/90% |
Whisper-Large-V3 加繁體提示 | 80% | 80% | 0% | 26% | 85%/69%/86% |
Whisper-Large-V3-Turbo | 47% | 78% | 24% | 28% | 85%/61%/87% |
Whisper-Large-V3-Turbo 加繁體提示 | 63% | 76% | 9% | 32% | 86%/58%/83% |
Taiwan-Tongues-ASR-CE | 73% | 73% | 0% | 16% | 75%/66%/79% |
Breeze-ASR-26 | 77% | 77% | 0% | 18% | 78%/76%/78% |
Breeze-ASR-26 加繁體提示 | 76% | 76% | 0% | 18% | 78%/72%/78% |
Whisper 預設會輸出簡體字。Large V3 呼叫時帶一句繁體中文提示,例如「以下是台灣繁體中文的句子」,24 段只剩 1 段出現簡體字。Turbo 加了提示,簡體字仍占 9%。Taiwan-Tongues-ASR-CE 的字錯率最低,但會把 LINE 聽成別的字,數字和英文要再檢查。
聯發科與陽明交大的 Breeze-ASR-26 其實是台語辨識模型,會把台語轉成華語漢字。我們只有華語錄音,所以看的是它聽華語的表現。它不用加提示就全部輸出繁體,關鍵資訊聽對 77%,合成男聲的成績是所有設定裡最好的。英文詞一樣容易錯,例如 ERP 被聽成 APP,LINE 被聽成「欄」。
文字轉語音與向量檢索
文字轉語音用聯發科與台大發表的 BreezyVoice 念了 5 句,每句音檔約 6 到 8 秒,產生卻要 14 到 15 秒。適合預先產生的語音通知,不適合即時對話。
向量檢索用 20 則網站服務 FAQ 和 20 個口語問題測試,例如「用手機看會不會跑版」。embeddinggemma-300m 排第一的結果就是正確答案的比例是 95%,加上官方建議的前綴後是 100%。不用模型的字面比對只有 50%。
速度、token 用量與硬體:同一題誰先回、誰最耗資源
每題回覆時間的中位數在 1.7 到 3.6 秒之間。最快的是 Gemma 4 31B、Llama 4 Maverick、Gemma 4 26B-A4B,都在 1.7 到 1.8 秒。推理模型每題平均輸出 300 到 511 個 token,一般模型只有 51 到 112 個。Gemma 4 官方也支援思考模式,這次在平台上沒有開,所以算一般模型。
模型 | 回覆時間中位數(秒) | P90(秒) | 輸出速度(token/秒) | 每題平均輸出 token |
|---|---|---|---|---|
Gemma 4 31B | 1.7 | 4.3 | 107 | 64 |
Llama 4 Maverick | 1.8 | 3.7 | 51 | 51 |
Gemma 4 26B-A4B | 1.8 | 4.3 | 79 | 94 |
TAIDE | 1.9 | 4.5 | 63 | 55 |
Nemotron 3 Super | 2.1 | 5.2 | 116 | 491 |
Llama 3.3 70B | 2.2 | 8.4 | 35 | 70 |
Gemma 4 E4B | 2.2 | 9.0 | 52 | 112 |
Devstral 2 | 2.3 | 6.8 | 41 | 71 |
Gemma 3 12B | 2.3 | 7.5 | 43 | 88 |
Mistral Large 3 | 2.3 | 6.5 | 31 | 66 |
gpt-oss-120b | 2.4 | 5.3 | 76 | 337 |
Mistral Small 3.2 | 2.5 | 13.5 | 46 | 64 |
Phi-4 multimodal | 2.5 | 7.5 | 41 | 64 |
Nemotron 3 Ultra | 2.7 | 5.6 | 73 | 300 |
Llama 3.1 405B | 2.8 | 11.5 | 25 | 76 |
gpt-oss-20b | 3.6 | 13.0 | 80 | 511 |
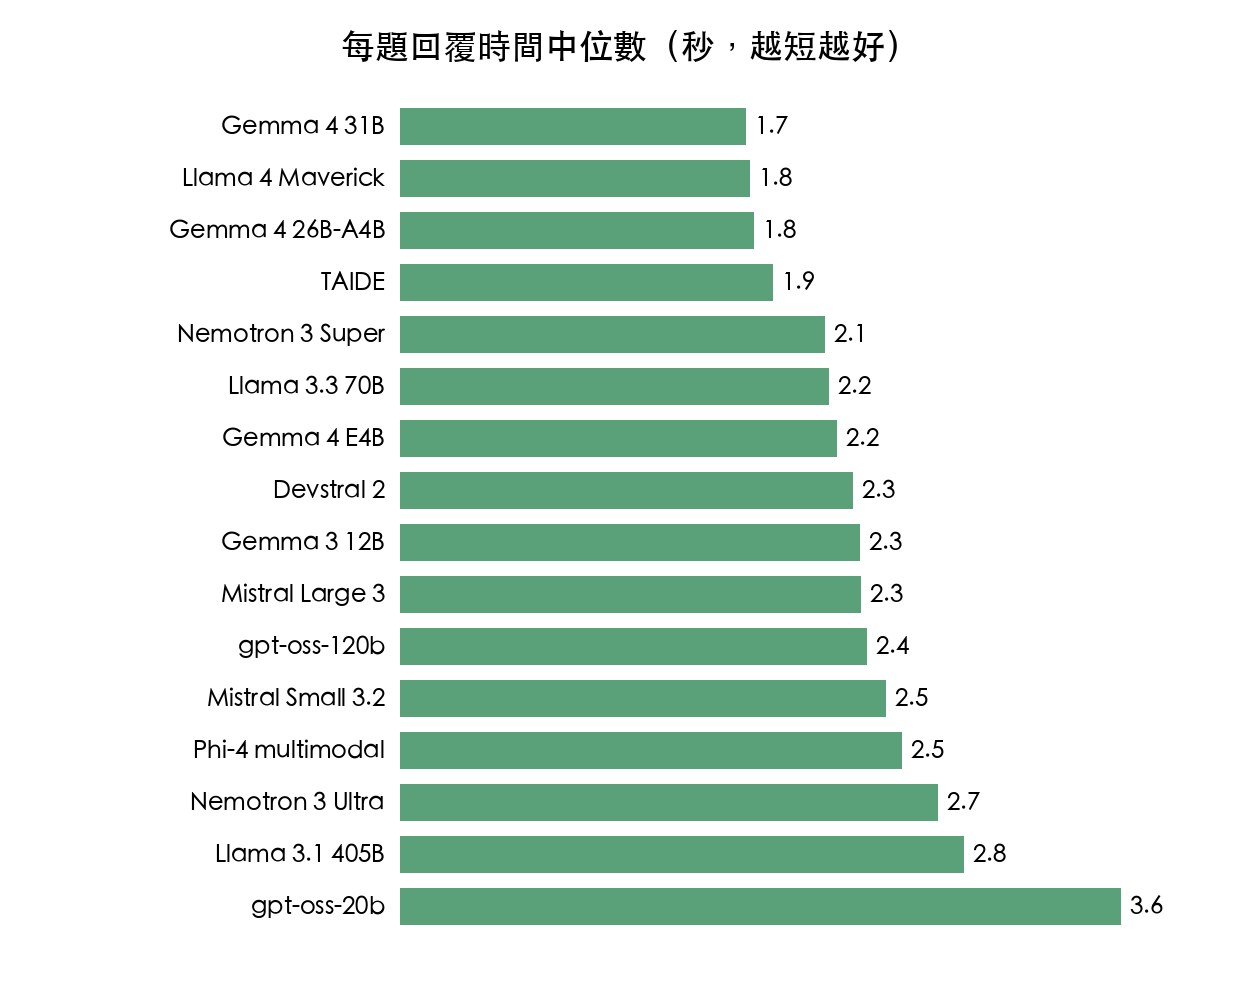
秒數包含網路和平台排隊,代表在這個平台上的體感。自己架設時,速度取決於你的顯示卡和同時使用的人數。Phi-4 multimodal 與 Gemma 3 12B 的速度不含那 11 題結果異常的工具呼叫。
推理模型在多步驟計算上比較準,代價是輸出量大。用雲端服務按 token 計費時,輸出那部分的費用會跟著放大好幾倍,總帳單還要看輸入與輸出的價差。token 成本怎麼管,可以看LLM API 帳單管理。
自架要多少硬體
模型名稱裡的數字是參數量。MoE 架構的模型每次只啟用一部分參數,所以跑得比較快。但記憶體仍要放得下整個模型。
官方說的硬體需求差距很大:小模型手機就能跑,最吃硬體的要十幾張資料中心等級的顯示卡。下表整理官方寫在 model card 或發表文章裡的說法。
模型 | 官方說的硬體需求 | 前提 |
|---|---|---|
手機、Raspberry Pi 這類裝置就能離線執行 | 官方主打裝置端 | |
16GB 記憶體 | 官方的 MXFP4 量化版 | |
單張 80GB 的 H100 | 未量化的 BF16 權重;量化版可用一般顯示卡 | |
單張 80GB 的顯示卡,例如 H100 | 官方的 MXFP4 量化版 | |
至少 4 張 H100 等級的顯示卡 | 官方建議的最低配置 | |
至少 8 張 H100 80GB | BF16 版;NVFP4 版可用單張 B200 或 DGX Spark | |
單一伺服器節點 | 官方的 FP8 量化版 | |
一台 8 張 A100 或 H100 的伺服器 | NVFP4 量化版;FP8 版要 H200 或 B200 | |
至少 16 張 H100,或 8 張 H200 | BF16 版 |
表裡很多數字的前提是「量化版」,也就是把權重壓縮來省記憶體。自己架設時,量化版要用自己的題目再確認一次準確度。地端硬體的選擇,可以參考NVIDIA DGX Spark 介紹。
台灣企業怎麼選:六種情境的建議組合,以及不適合自架的時候
沒有一個模型每項都第一。依用途挑主力、再配一個備援,是比較實際的做法。
情境 | 主力 | 備援 | 要注意 |
|---|---|---|---|
LINE 客服回覆 | Nemotron 3 Ultra 或 Gemma 4 31B | TAIDE(潤飾成台灣口吻) | 上線前用台灣題目測用語 |
報價與文件結構化 | gpt-oss-120b | Nemotron 3 Super | 金額交給程式算,模型只拆品項 |
內部知識問答 | embeddinggemma-300m 搭配 Gemma 4 31B | gpt-oss-20b | 先整理好 FAQ 與文件 |
程式輔助 | gpt-oss-120b | Nemotron 3 Ultra | 用自己的程式碼庫再測一次 |
語音與會議紀錄 | Whisper Large V3 加繁體提示 | Taiwan-Tongues-ASR-CE | 人名、數字、英文要人工確認;客人講台語要另外測 |
單據與照片辨識 | Llama 4 Maverick 或 Mistral Large 3 | Gemma 4 26B-A4B | 數量與加總要用程式檢查 |
什麼時候不建議自架
- 資料可以出境、用量又小(一個月幾千次呼叫)時,商用 API 的帳單通常比顯示卡便宜。
- 公司沒有人能維護 GPU 主機、處理模型更新與資安修補。
- 需要頂尖的推理或寫程式能力,開源模型在你的題目上還不夠用。
反過來說,資料不能出境、用量穩定而且量大時,自架開源模型就值得認真評估。導入前的資料權限盤點,可以看AI 導入前的資料權限盤點;整體規劃可以看企業 AI 導入完整指南。
如果你在比較「自己做」和「直接用 ChatGPT」的差別,客製化 AI 系統與 GPT 套殼的判斷方式會有幫助。
選模型最花時間的一步,是用自己的題目測一次。題庫怎麼設計、評分怎麼自動化、哪些情境該自架,這類評估在我們的AI 顧問服務範圍內。想先聊聊你的情境,可以加我們的 LINE 官方帳號,或寫信到 [email protected]。
ℹ️我們怎麼看
這次測試讓我們更確定一件事:開源模型的差距,大多出現在「台灣」和「串接」這兩塊。
懂台灣用語、沒資料時不亂編、金額交給程式算,是上線前最該確認的三件事。
我們的取捨是:用語交給台灣調校過的模型潤飾,計算交給程式,工具呼叫交給穩定的模型。
對你來說,最值得投資的是一份自己的考卷。模型會一直換,考卷可以一直用。
ℹ️我們自己也每天在用
我們公司自己每天就在跑 20+ 個 AI 流程,從會議紀錄到報價草稿都有。這次的評測程式與題庫,也是用同樣的方法建出來的。
如果你想知道這套方法放到你的公司會長什麼樣子,可以看看AI 顧問服務。
Q開源 AI 模型有哪些?台灣企業可以用哪幾個?
常見的有 OpenAI 的 gpt-oss、Meta 的 Llama、Google 的 Gemma、Mistral AI 的 Mistral 與 Devstral、NVIDIA 的 Nemotron,以及國科會推動、國研院開發的 TAIDE。我們實測的 16 個模型裡,綜合成績的第一群是 gpt-oss-120b、Nemotron 3 Ultra、Nemotron 3 Super、Gemma 4 31B、gpt-oss-20b,總分 93% 到 94%。要不要用中國或中資的模型,要看你的資安規範。
QTAIDE 好用嗎?跟 Google 官方的 Gemma 3 12B 差在哪?
在我們的題目上,TAIDE 的繁中用語比同底座的 Google 官方對話版多對 3 題,台語多對 1 題,但寫程式少對 3 題。適合放在需要台灣口吻的環節,計算與系統串接交給其他模型。
Qgpt-oss-20b 和 120b 差在哪?
兩個在我們的商業計算題都全對,總分也同在第一群。120b 的繁中用語與寫程式比較好。20b 偶爾會留英文不翻、寫出大陸用語,台語翻譯還整句輸出簡體字,也有題目想太久沒有回答。硬體差最多:OpenAI 官方說 20b 用 16GB 記憶體就能跑,120b 則要一張 80GB 的顯示卡,兩者都是指官方的 MXFP4 量化版。
Q開源模型會混進簡體字或大陸用語嗎?
會。我們測的 16 個模型裡,多數會寫出「視頻、反饋、質量」這類大陸用語,少數會整句輸出簡體字。上線前要用台灣題目檢查,必要時加一層用語檢查。
Q公司資料不能出境,該自架開源模型還是用商用 API?
資料不能出境時,用量小可以租國內機房的 GPU 跑開源模型,用量大再評估地端自架。資料可以出境、用量又小時,選有資料保護條款的商用 API 通常比較划算。先用自己的題目測過再決定。
Q開源 AI 模型可以商用嗎?
多數可以,但條件不同。gpt-oss、Gemma 4、Mistral Large 3 採 Apache 2.0,可以直接商用。Llama 的社群授權規定,版本發布時月活躍用戶超過 7 億的公司要另外申請。Devstral 2 規定全球月營收超過 2,000 萬美元的公司,要另外取得商業授權。TAIDE 的條款沒有禁止商用,但要同時遵守 Gemma 使用條款。商用前請讀官方授權原文。
AUTHOR
恆遠數位編輯團隊
想了解更多?看看我們的相關服務
相關文章
PentAGI 是什麼?開源 AI 滲透測試工具的功能、成本與企業導入評估
Feynman AI 是什麼?它算終端機嗎?開源 AI 研究代理白話入門,跟 ChatGPT、Claude Code 差在哪
AI 導入費用要多少?依 4 種導入型態拆解:工具訂閱、流程自動化、RAG 知識庫、客製化 AI 系統與 3 個隱藏成本
Claude 新創計畫怎麼申請?免費一年 Team、US$1,000 API 額度與資格條款整理
Laya vs Jev 怎麼選?五個決策點:資料能不能出境、延遲、標註資料、信心門檻與選項數量
留言(0)
尚無留言,成為第一個留言的人吧!